Словарь(dict) - вторая часть
KarmanovichDev❗️Перед тем как читать данную статью, настоятельно рекомендую ознакомиться с другой моей статьёй, которая даёт базовое понимание о типах и структурах данных - https://telegra.ph/Tipy-i-struktury-dannyh-06-16.
первая часть - https://telegra.ph/Slovardict-06-28
Во второй части статьи хочется рассказать информацию, касающуюся именно python.
Начнём с того, что до python 3.6 словари были неупорядоченной коллекцией, то есть не хранили порядок вставленных в них ключей. В python 3.6 это стало деталью реализации языка, но на это не рекомендовалось полагаться(нужно было продолжать использовать например OrderedDict, когда вам был важен порядок вставки). Начиная с python 3.7 порядок вставки элементов является гарантированной функциональностью, а не просто деталью реализации языка.
Но что побудило разработчиков сделать словари упорядоченными коллекциями? Разве тот же OrderedDict настолько востребован? Не знаю, как у вас, но лично я пользовался им, всего один раз в коммерческом фриланс проекте, и не готов сказать, что это было лучшее решение.
Но, несмотря на мой опыт, вполне возможно, что многие люди, правда, используют OrderedDict, в тех или иных ситуациях, хотя я всё ещё считаю, что это небольшое кол-во разработчиков в процентном соотношении.
Вернёмся к предыдущему вопросу: что побудило разработчиков сделать словари упорядоченными коллекциями? Ответ может оказаться неожиданным, ведь эта фича является побочным эффектом другой фичи, которая была нацелена на другое улучшение словарей.
Как выглядел словарь под капотом до 3.6/3.7? Это была разряженная таблица, которая хранила 24-х байтные записи, содержащие хеш, ключ и значение. "Разряженная" в данном контексте означает, что относительно большой процент записей являются "пустыми". Кол-во памяти выделяемое на такую таблицу было равно:
old_size = 24 * n, где n кол-во записей.
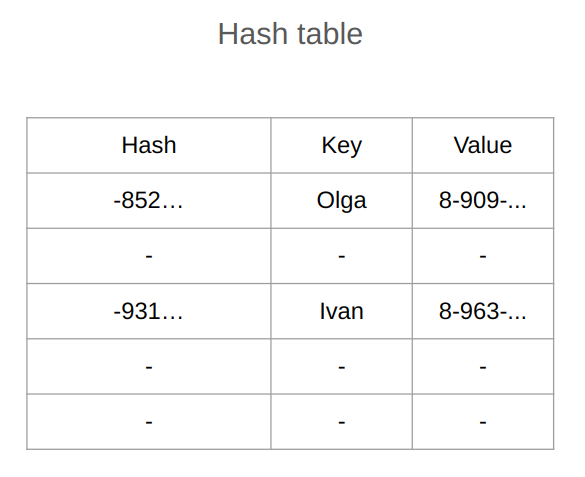
Raymond Hettinger, посчитал этот подход к хранению данных очень неэффективным использованием ресурсов и предложил другой вариант, который не затрагивал бы никаких других алгоритмов хеш-таблицы, но смог бы уменьшить размер словарей.
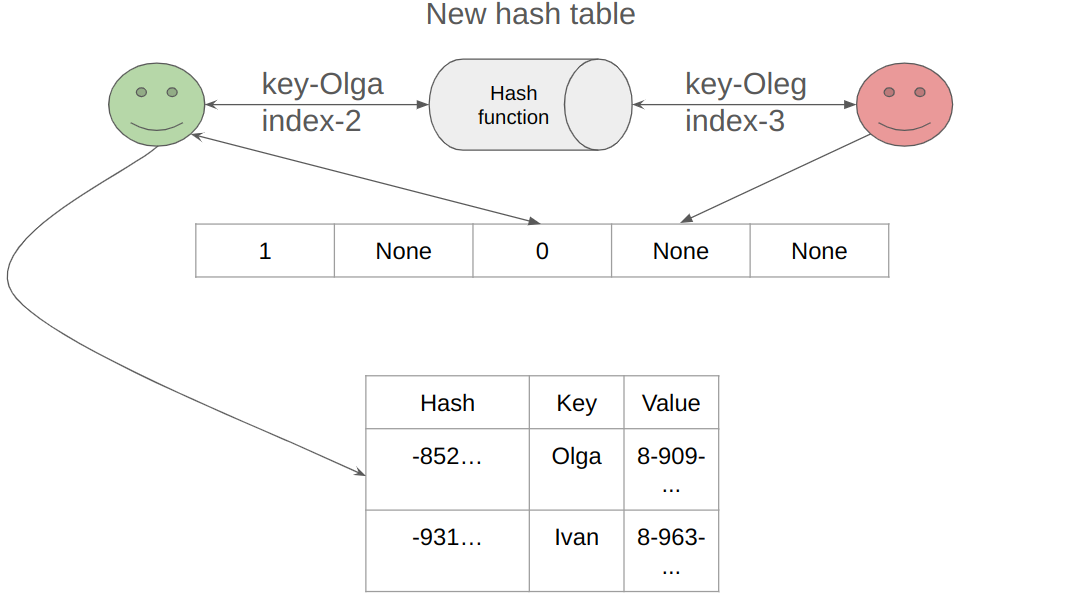
Его идея заключается в том, что нам нужна плотная таблица с записями и разряженная таблица индексов, которая ссылается на таблицу с записями:
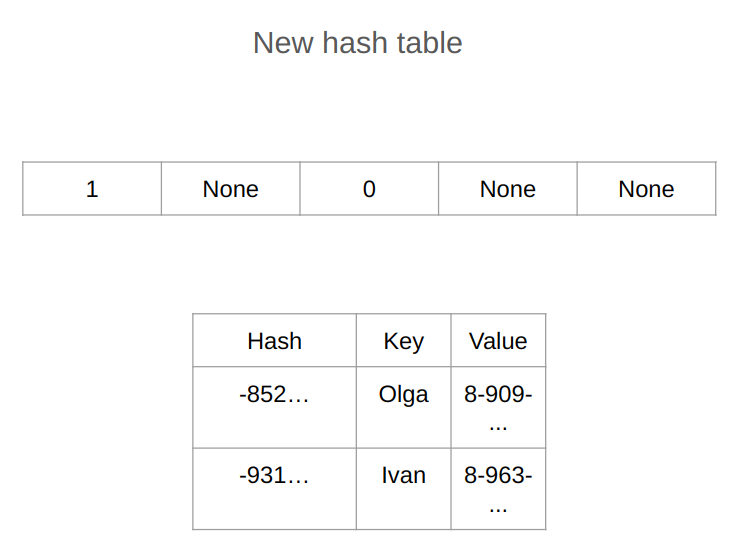
Получается теперь, когда мы вычисляем хеш и индекс теперь уже таблицы с индексами, мы попадаем в ячейку с индексом два и получаем значение 0, которое является индексом требуемой нам записи в плотной таблице с записями. Если из таблицы с индексами мы получим None, значит, данного ключа ещё/уже не существует:
Новый размер по предложенной схеме Raymond Hettinger, считается так:
new_size = 24 * n + sizeof(index) * t
sizeof(index) это память, выделенная на один индекс. t - кол-во индексов. n - всё так же отражает кол-во записей в плотной таблице.
Автор упоминает, что sizeof(index) может занимать 1 байт для меленьких словарей, 2 байта для больших и sizeof(Py_ssize_t) для огромных. Не будем углубляться в рамках статьи в то, что значит sizeof(Py_ssize_t). Главное, вы должны понимать, что размеры таблицы индексов имеют сильно меньший размер, чем таблицы записей.
В своём примере автор показал разницу на словаре из трёх ключей:
Старый размер составлял 192 байта (восемь 24-байтовых записей), а новый размер - 80 байтов (три 24-байтовые записи плюс восемь 1-байтовых индексов). Это дало сжатие в 58%.
Также стоит упомянуть, что новый подход в хранении словарей не останавливается только на улучшениях, связанных с экономией памяти и появлению упорядоченности, ещё мы получили(далее - слова Raymond Hettinger):
Ускорение итерирования - ранее функции Keys(), Values() и Items() циклически обрабатывали разреженную таблицу, пропуская свободные места в хеш-таблице. Теперь ключи/значения/элементы могут проходить напрямую по плотной таблице, используя меньше обращений к памяти.
Быстрее меняется размер - изменение размера происходит быстрее и затрагивает меньше фрагментов памяти. Ранее каждая запись хеша/ключа/значения перемещалась или копировалась во время изменения размера. В новом макете обновляются только индексы. По большей части записи хеша/ключа/значения никогда не перемещаются (за исключением случайной замены, чтобы заполнить дыру, оставшуюся в результате удаления).
Как оказалось, и во второй части статьи не удалось охватить всё, что хотелось рассказать. Надеюсь, основной массе читающих будет достаточно и двух частей. Считаю этого более чем достаточно, чтобы заинтересовать человека, и заставить его найти недостающую информацию самому, если тема ему близка.