Типы и структуры данных
KarmanovichDevЕсли задуматься, то на базовом уровне, всё, что делают программисты это работают с данными.
Мы получаем данные извне, обрабатываем их, модифицируем, кладём в хранилище и/или возвращаем клиенту. Все остальные вещи, лишь помощники для осуществления операций над данными.
Будь то парсер сайта, веб/мобильное/консольное приложение, ML модель, которая предсказывает курс валют на бирже, датчик микроконтроллера, или генератор анекдотов, всё это программы, которые работают с данными.
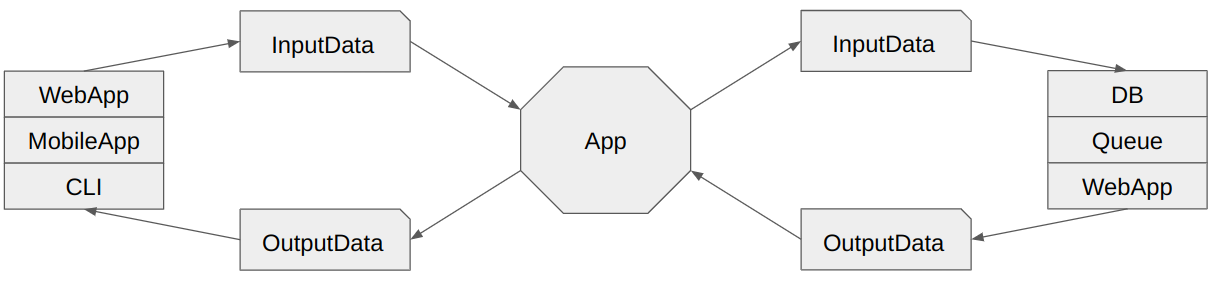
Даже если опуститься на самый низкий уровень, то всё что делает процессор ПК, обрабатывает сигналы, состоящие из данных, и производит возможные вычисления над нужными данными.
Исходя из предыдущей информации, можно сделать вывод: работа с данными - это важнейшая часть любого приложения.
Давайте обратимся к computer science и узнаем, что же такое "данные" а в частности "тип данных". В разных местах я находил разные определения:
- Множество значений и операций над этими значениями
- Класс данных, характеризуемый членами класса и операциями, которые могут быть к ним применены
- Категоризация абстрактного множества возможных значений, характеристик и набор операций для некоторого атрибута
- Категоризация аргументов операций над значениями, как правило, охватывающая как поведение, так и представление
- Допустимое множество значений
Все они являются корректными, просто описывают суть разными словами или на разных уровнях абстракции.
Например стек(stack):
Элементы в стеке кладутся в строгом порядке друг за другом. Первый взятый элемент со стека является последним добавленным. Обычно работать можно только с последним добавленным элементом в стек.
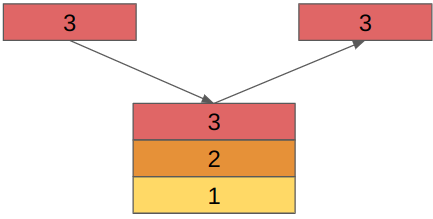
Базовые операции:
- push(x) - Добавить элемент “x“ на вершину стека
- pop - Получить и удалить элемент с вершины стека
Расширенные операции:
- Получить количество элементов в стеке
- Проверка наличия элемента в стеке
Или очередь(queue):
Добавление элементов в эту структуру данных образует очередь, где каждый новый элемент добавляется в конец очереди, а берём мы элементы из её начала.
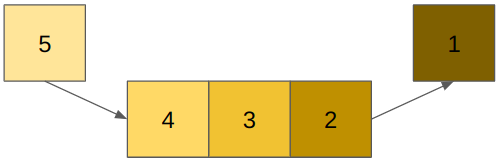
Базовые операции:
- enqueue(x) - Добавить “х” в конец очереди
- dequeue() - Удалить элемент из начала очереди
- count() - проверка кол-ва элементов в очереди
Обратите внимание, что в информации о типах данных нет никакого упоминания о деталях реализации:
- Как данные должны лежать в памяти?
- Сколько памяти будет потрачено?
- С какой алгоритмической скоростью должна быть выполнена каждая операция?
Всё потому, что это абстрактные типы данных(АТД), они лишь описывают интерфейс взаимодействия и "говорят", что должен уметь делать объект, реализующий этот АТД.
Отличный пример:
Массив - упорядоченная коллекция, обычно может содержать в себе элементы одного типа. Поддерживаемые базовые операции(CRUD операции используя индекс), инвертирование, сортировка, получение среза элементов.
связный список - …
двусвязный список - …
Эти типы данных представляют собой коллекции объектов с одинаковой функциональностью, но имеют разную реализацию и алгоритмическую сложность:
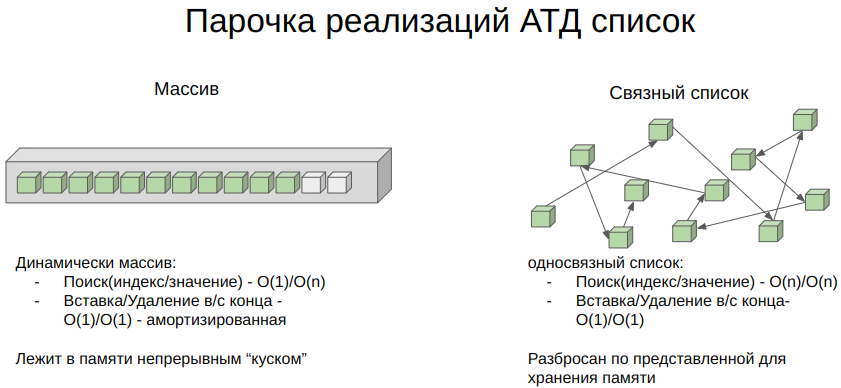
Обе этих структуры данных являются реализациями АТД список(list).
Ниже представлена подробная иерархия АТД:
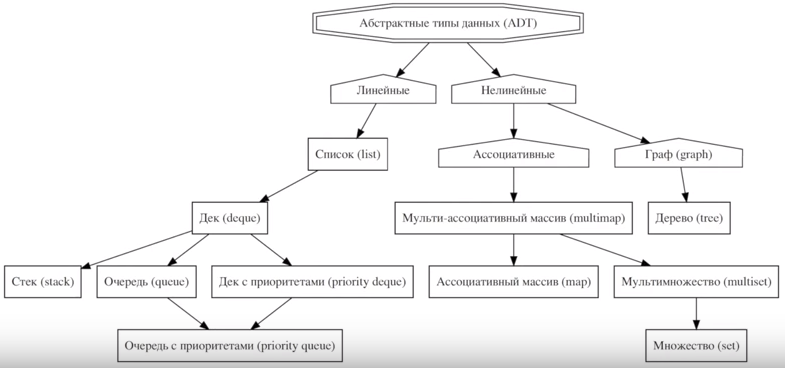
Если вернуться к тому, что я пишу на python, то можно обнаружить, что при написании программ я использую такой тип данных как list(АТД), который под капотом имеет реализацию динамического массива.
Это базовая информация о типах и структурах данных. Статья основана на моей презентации, где вы найдёте намного больше информации об этой теме.