Словарь(dict) - первая часть
KarmanovichDev❗️Перед тем как читать данную статью, настоятельно рекомендую ознакомиться с другой моей статьёй, которая даёт базовое понимание о типах и структурах данных - https://telegra.ph/Tipy-i-struktury-dannyh-06-16.
Давайте разбираться, что из себя представляет словарь(dict).
Начнём с того, что словарь(dict) является реализацией АТД ассоциативный массив.
Из вики: Ассоциативный массив — абстрактный тип данных (интерфейс к хранилищу данных), позволяющий хранить пары вида «(ключ, значение)» и поддерживающий операции добавления пары, а также поиска и удаления пары по ключу.
Итак, словарь, это коллекция пар ключ-значение. Пойдёмте, убедимся в этом:
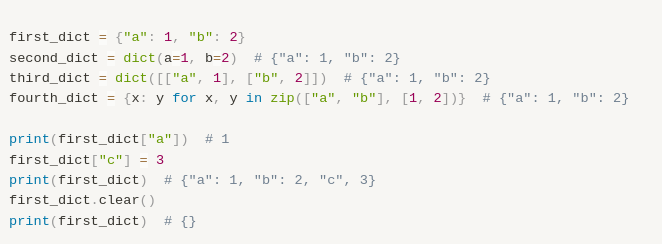
Начиная с python 3.7 словари официально являются упорядоченными коллекциями. Ранее они не хранили порядок вставленных ключей.
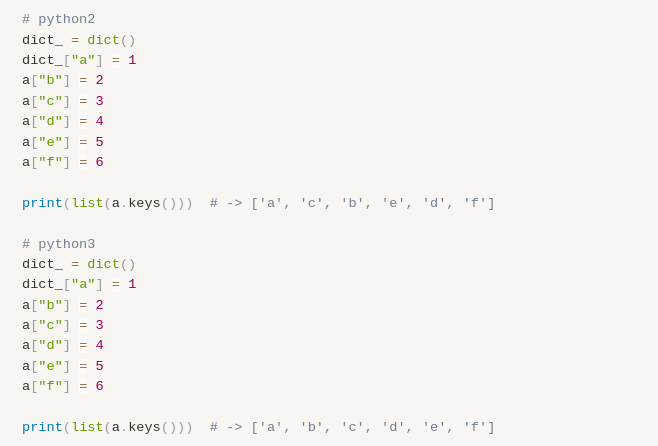
На самом деле "порядок" вставки ключей - это сайд эффект, который получился в процессе оптимизации словарей, но об этом во второй части статьи 😊.
Словарь, очень интересная структура данных, ведь его базовые операции в среднем выполняются достаточно быстро:
- Вставка ключа O(1)
- Поиск по ключу O(1)
- Удаление ключа O(1)
Почему так? Давайте разбираться! Сначала чуть лучше поймём, как устроена структура "под капотом". А "под капотом" у нас лежит хеш-таблица.
Из вики: Хеш-табли́ца — структура данных, реализующая интерфейс ассоциативного массива, а именно, она позволяет хранить пары (ключ, значение) и выполнять три операции: операцию добавления новой пары, операцию удаления и операцию поиска пары по ключу.
Процесс работы(хеш=хеш-сумма):
При попытке установить значение для некоторого ключа, требуется получить его хеш. Хеш, это преобразование любого объёма и типа информации, поддающемуся хешированию в уникальный набор символов.

Но как нам получить этот хеш?
Чтобы получить хеш, нам нужна хеш-функция. Эта функция и будет отвечать за то, что бы преобразовывать требуемые нам данные в уникальный набор символов.
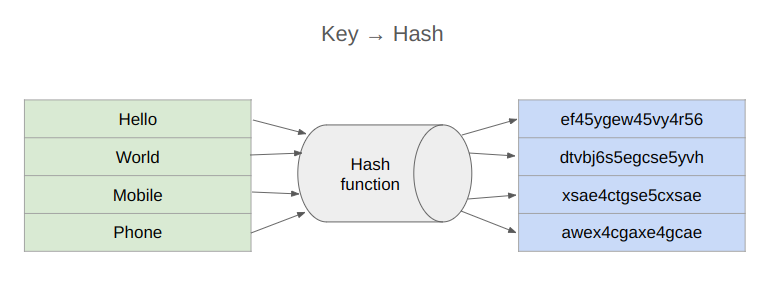
Любая хорошая хеш-функция соблюдает ряд требований:
- Получение хеш-суммы это необратимая операция, не должно быть алгоритма, чтобы вернуть хеш обратно в исходный формат данных. Можно только перебрать всё множество возможных вариантов, но это очень долго и дорого.
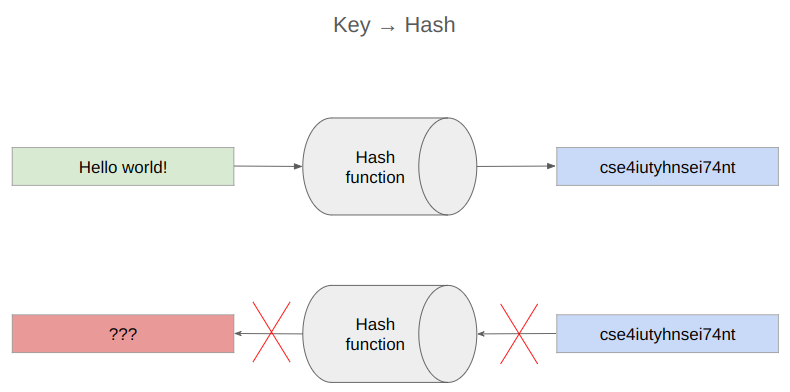
- Для одного и того же набора данных хеш-функция должна выдавать один и тот же хеш.
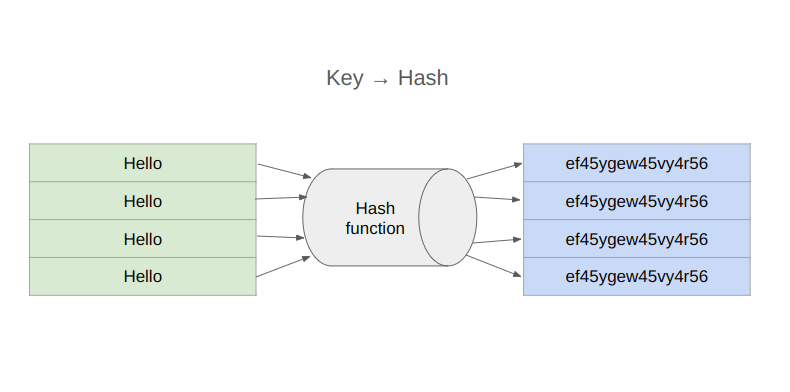
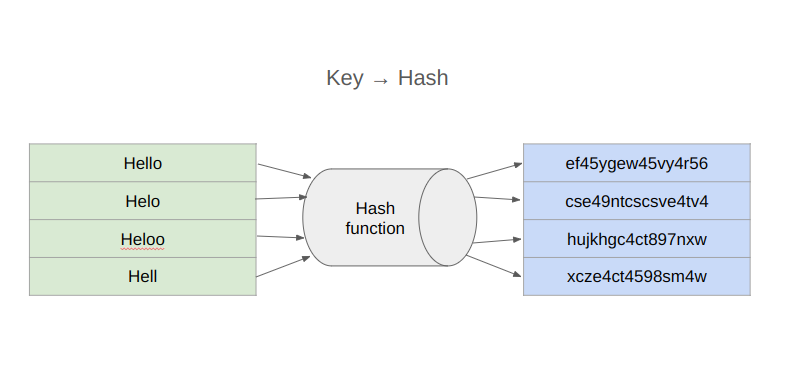
- Даже при минимальном изменении данных хеш должен сильно отличаться, чтобы нельзя было методом подбора понимать, какие данные были изначально. Это свойство называется лавинный эффект.
- Скорость! Даже большой объём данных должен быстро преобразовываться в хеш.
- Длина хеша всегда должна быть одинаковой, независимо от объёма хешируемой информации.
- Опционально - открытый исходный код, для возможности оценки эффективности и качества алгоритма.
Как можно представить себе хеш-таблицу?
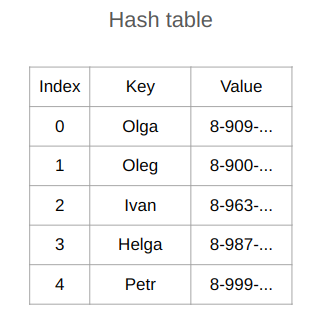
Обратите внимание, что здесь нам понадобится дополнительная логика, чтобы мы могли преобразовать полученный из хеш-функции хеш в индекс массива.
Будет ли это сразу делать изначально хеш-функция или будет дополнительный механизм, который сможет преобразовывать полученный хеш в индексы массива - детали реализации.
Давайте представим, что у нас ситуация, когда вычисление индексов - это отдельный шаг после получения хеш-суммы из хеш-функции. Тогда вот так будет выглядеть весь процесс работы с хеш-таблицей при добавлении в неё информации:
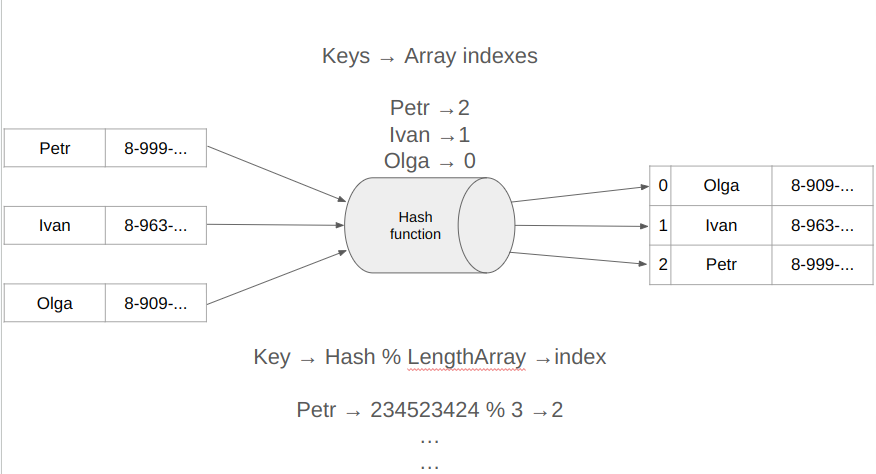
После того как мы узнаём индекс массива, мы можем за O(1) "добраться" до места, где лежат или куда нужно положить наши данные.
О массивах и не только я рассказывал тут.
Именно поэтому все базовые операции(get, set, delete) связанные с хеш-таблицей выполняются в среднем со сложностью O(1).
Почему в среднем? Что мешает нам всегда выполнять все операции за константную сложность? Коллизии хеш-функции!
Коллизия хеш-функции, это ситуация, когда два разных набора данных возвращают одну и ту же хеш-сумму.
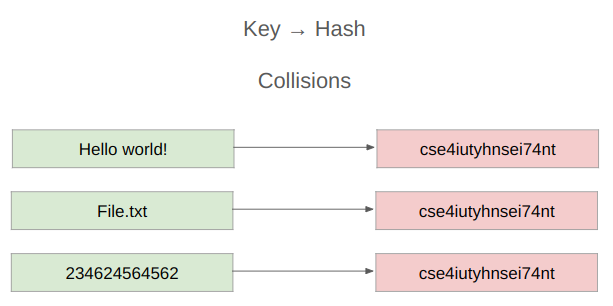
Это нормально! Нельзя придумать хеш-функцию, которая никогда не получает коллизий, но кол-во коллизий должно стремиться к нулю.
Начнём с того, что одно из правил, которым, должна соответствовать хеш-функция это одинаковая длина хеш-суммы.
Давайте даже представим, что длина нашей хеш-суммы 1млн символов, даже не хочу считать, какое огромное кол-во вариантов его значений, и как медленно будет работать эта хеш-функция, не говоря уже о кол-ве потребляемой памяти.
Но в мире бесконечное множество возможных данных, подмножеством которого будет являться возможные значения хеш-функции. А это значит, что нельзя охватить все возможные значения, если длина хеш-суммы имеет конечное значение.
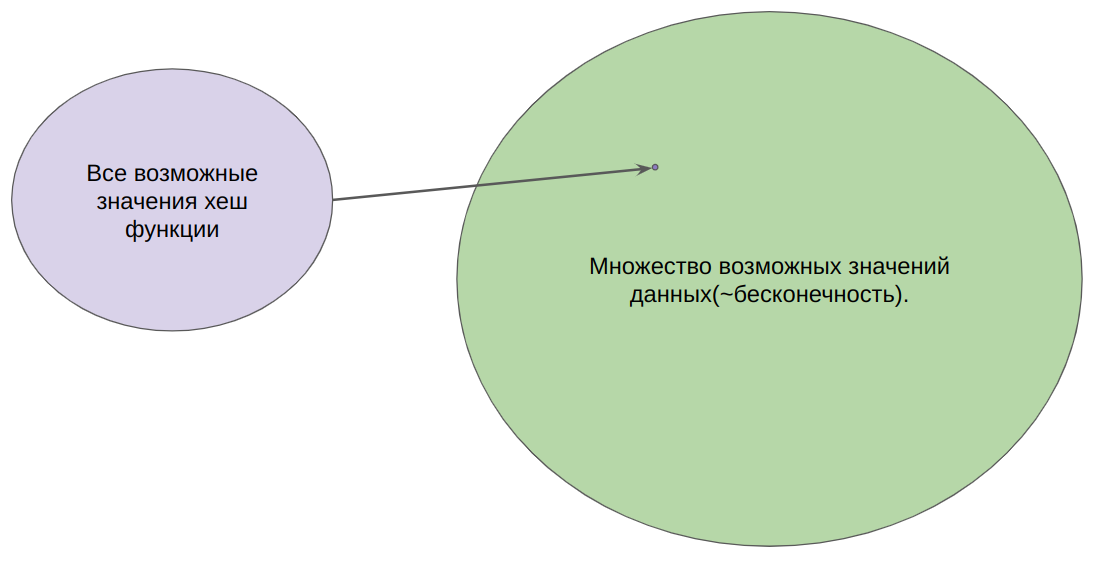
Несмотря на такое большое преобладание всевозможных вариантов данных над множеством значений хеш-функции, обычно проблема коллизий не так страшна, как может показаться на первый взгляд. Это не значит, что каждый третий ключ будет выдавать коллизию, хотя и по теории вероятностей это возможно.
Мы много говорили о хешировании, поэтому хочется сказать очевидный вывод: объект, который будет использоваться в качестве ключа, должен быть хешируемым.
Вернёмся к алгоритмической скорости базовых операций с хеш-таблицей, и какие проблемы доставляют нам коллизии.
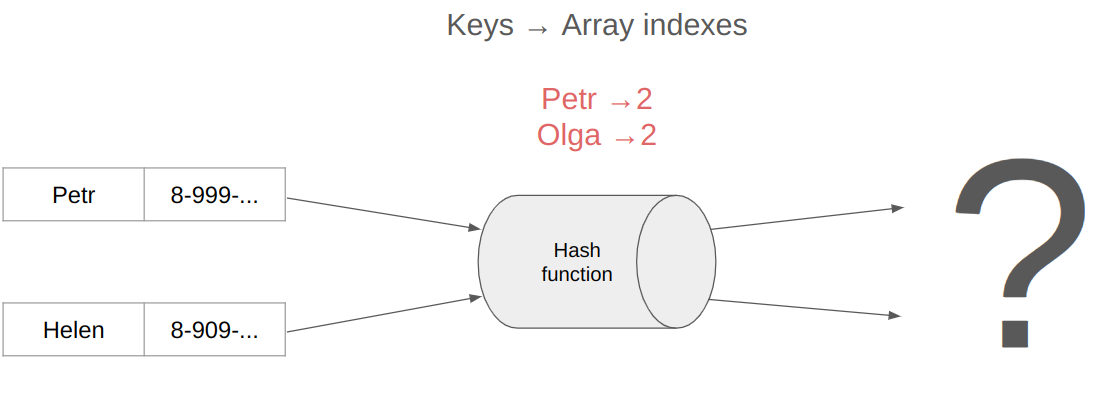
Что делать, если разные ключи имеют одинаковый индекс? Есть два стандартных метода борьбы с коллизиями в хеш-таблице:
- Метод открытой адресации
- Метод связных списков
Метод открытой адресации:
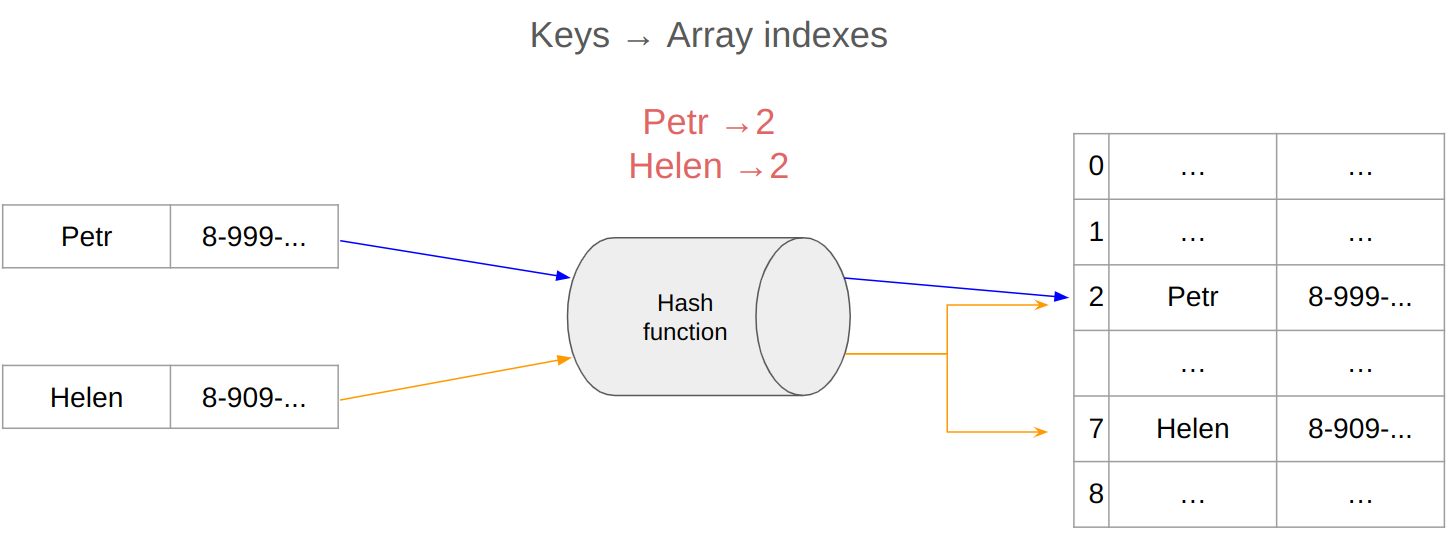
Когда мы пытаемся сохранить данные по ключу [Helen], в первый раз мы попадаем в ячейку, где уже лежат данные по другому ключу [Petr]. После, c помощью алгоритма(они бывают разными) мы вычисляем следующий индекс, куда мы попробуем сохранить наши данные. В нашем случае там не оказалось сохранённых данных, и мы сохранили свои данные именно туда. Кол-во операций, которое нам пришлось выполнить, было две(T(2)).
Нетрудно догадаться, что и поиск по ключу [Helen] теперь займёт у нас две операции. Первый раз мы найдём ключ [Petr], вычислим новый индекс, и только потом найдём нужный нам ключ [Helen].
С удалением всё точно так же(на самом деле, не всё так просто с удалением, но в рамках этой статьи, этого будет достаточно).
Метод связных списков.
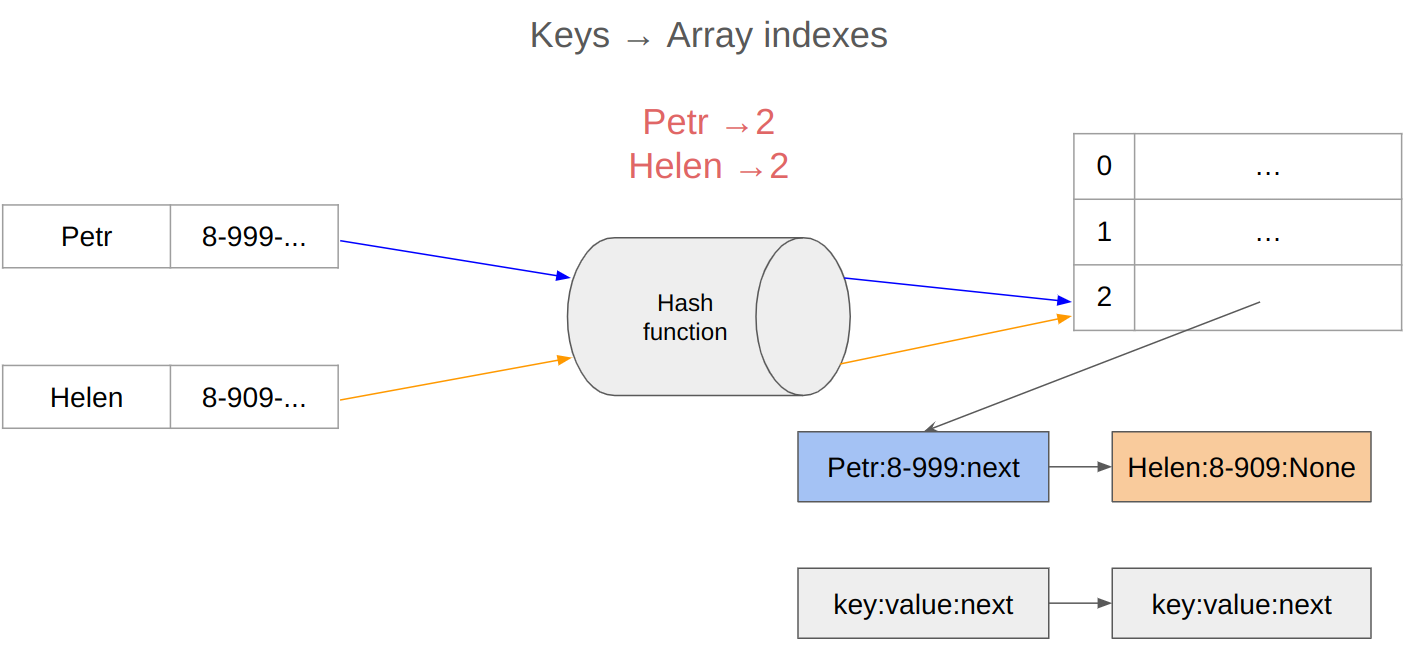
В случае связных списков мы не вычисляем новый индекс для вставки. Мы получаем ссылку на связный список, получаем его первый элемент и проверяем, если ключи не сходятся, идём к следующему элементу, пока не найдём нужный или не упрёмся в конец связного списка.
Подведём итог: в худшем случае, если наша хеш-функция будет настолько плоха, что будет возвращать нам одинаковый хеш на любой ключ, то сложность всех базовых операций резко превратится в O(n).
В рамках одной статьи на эту тему я не могу ни углубиться в отдельные её части, ни описать всё, что хотел(много информации). Предлагаю поступить так: вдобавок к вашей реакции в целом от статьи, ставить дополнительную реакцию ➕. Я уже добавил её в возможные реакции:
В зависимости от количества этих самых ➕ я буду понимать, насколько востребовано углубление в ту или иную тему.
Во второй части статьи мы можем:
- Завершим разбор хеш-таблиц.
- Добраться до объяснения реализации в python(старой и новой версии).
- Написать свой упрощённый вариант хеш-таблицы с помощью класса, для ещё лучшего понимания механизма работы.
- Возможно, более глубоко погрузимся в реализацию алгоритмов борьбы с коллизиями и не только.