Список(list)
KarmanovichDev❗️Перед тем как читать данную статью, настоятельно рекомендую ознакомиться с другой моей статьёй, которая даёт базовое понимание о типах и структурах данных - https://telegra.ph/Tipy-i-struktury-dannyh-06-16.
Что же такое список(list) в python?
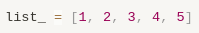
Для начала упомянем, что список является структурой(структурированным типом) данных. В любой структуре данных предполагается, что она может содержать в себе другие типы(примитивы) и структуры данных. Список не исключение:
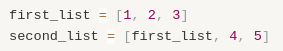
Списки также могут содержать в себе другие списки:
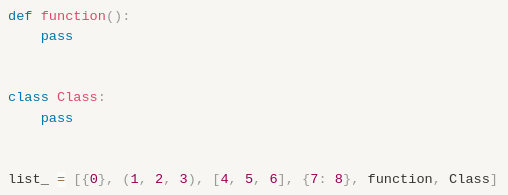
В целом списки могут содержать в себе всё что угодно(любой объект):
Даже сами себя:
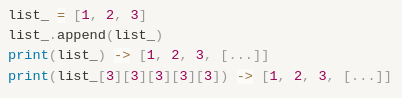
На основе предыдущих примеров вы должны были заметить, что списки могут содержать в себе неоднородные данные(разные типы и структуры данных). Это свойство списков называется гетерогенность.
Давайте вспомним/узнаем, какая алгоритмическая сложность базовых операций со списком(n = кол-во элементов структуры данных):
- Поиск по индексу - O(1)
- Поиск по значению - O(n)
- Вставка в конец - амортизированная O(1)
- Вставка в произвольное место - O(n)
Перед тем, как разобрать эти примеры, стоит рассказать, что реализация списка(абстрактный тип данных) в cPython это массив(array) и в памяти он лежит одним "куском":
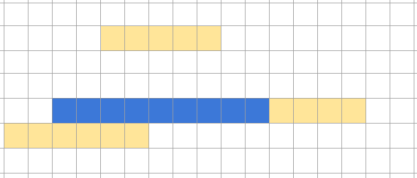
Прошу не путаться из-за названия "список", так как есть такая реализация АТД список, как "связный список". Реализация хранения в памяти там прямо противоположная: все элементы лежат в памяти беспорядочно, и каждый элемент знает своё значение и ссылку на следующий элемент. Есть ещё двусвязные списки. Их отличие в том, что элементы списка знают не только о следующем, но и о предыдущем элементе.
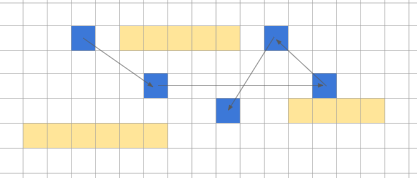
В каждой из реализаций есть свои плюсы и минусы, но эта статья не об этом.
Вернёмся к спискам(массивам) в python
Поиск по индексу - O(1):
Прежде чем честно рассказывать, почему поиск по индексу имеет такую высокую скорость, стоит упомянуть одну деталь о списках, которая, возможно застанет вас врасплох на короткий промежуток времени: список(массив) на самом деле состоит из объектов одинакового размера.
Да, да, несмотря на то, что в вашем коде вы можете поместить в список как строку в тысячу символов, так и пустую строку, в оперативной памяти(в массиве) будут лежать объекты одинакового размера.
Как это возможно? Возможно, кто-то из вас подумает, что из списка выбирается объект самого большого размера, и все остальные объекты находятся в состоянии, когда не весь предоставленный им объём памяти может быть заполнен, дабы удовлетворять условию, что все объекты одинакового размера:
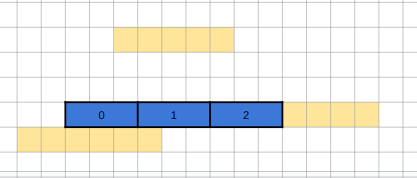
К счастью это не так. Даже страшно подумать о производительности и рентабельности такой реализации списка в целом. Представьте, что ваш тысячный добавленный объект оказался больше, чем любой добавленный ранее... Такое поведение могло бы очень сильно разочаровать вас😊
На самом деле в массиве не хранятся конкретно те объекты, которые вы сохраняете в них. В них хранятся лишь "ссылки" на реальные объекты. В python в целом всё работает на ссылках.
Каждая такая ссылка занимает одинаковое кол-во памяти, скажем что это "Х". Зная, где в памяти лежит начало списка(первый элемент), требуемый индекс и размер одной ссылки, всё, что нам нужно, это умножить индекс на размер одной ссылки, и мы получим размер(количество памяти), сколько нужно отступить от начала списка, чтобы найти требуемый элемент.
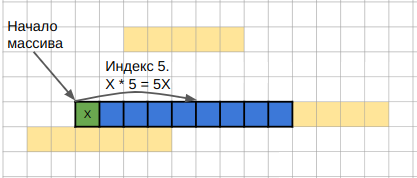
Остаётся пару вопросов: что это за ссылки и где лежат реальные объекты?
Всё просто, это ссылки как раз таки на реальные объекты, которые лежат так же в оперативной памяти, но уже не одним "куском" а "хаотично".
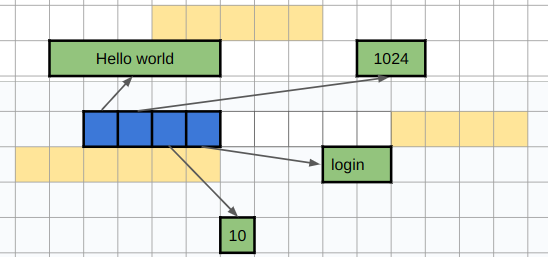
Именно так и реализуется свойство гетерогенность в массиве с сохранением алгоритмической скорости доступа по индексу.
❗️Далее для упрощения на изображениях данные будут лежать сразу в массиве, но не забывайте, что на самом деле там лежат лишь ссылки на реальные объекты.
Поиск по значению - O(n)
Тут всё просто: нужно начиная с первого элемента проверять, не равняется ли он тому, который мы ищем:
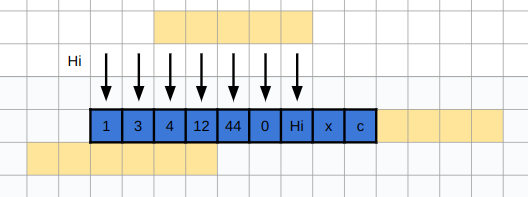
В данном случае мы нашли требуемый элемент с седьмой попытки из девяти возможных(длина массива). Могли найти и с первой. Если представить бесконечность подобных поисков, то по теории вероятности, все варианты будут равнозначны, и получается, что в среднем количество операций будет T(n * 0.5), но в асимптотической сложности(при количестве элементов, стремящихся к бесконечности) константы, не влияющие на результат, отбрасываются и мы получаем O(n).
Вставка в конец - амортизированная O(1):
Снова, чтобы быть максимально честным с самого начала, мне нужно рассказать две вещи:
- При достижении определённого размера массивам нужно увеличить или уменьшить свой размер. При увеличении это ведёт к "вытаскиванию" массива из памяти и вставке его в новое подходящее место. Эта процедура имеет сложность O(n) так как нужно каждый элемент переместить в новое место.
- Для предотвращения частых перемещений массива в памяти при его очередной инициализации выделяется "немного" свободного места для предстоящих добавлений элементов. Чем больше массив, тем большее количество элементов выделяется под предстоящее заполнение. Примерная последовательность выделения количества элементов массива - 0, 4, 8, 16, 25, 35, 46, 58, 72, 88, …
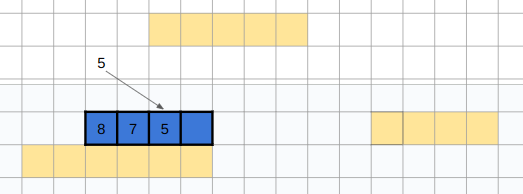
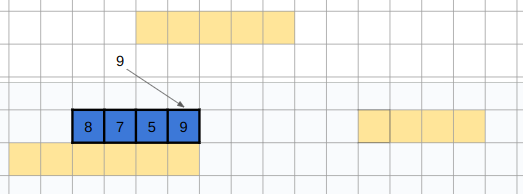
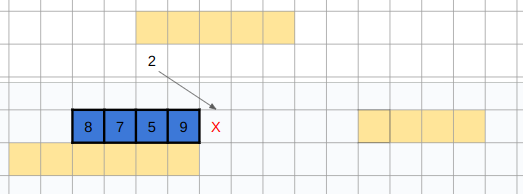
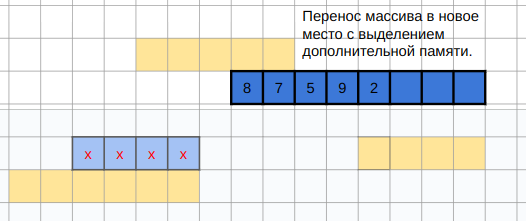
А теперь вернёмся к сложности. При вставке "5" и "9" сложность была O(1), но как только мы захотели вставить "2", нам пришлось перенести весь массив в новое место с дополнительно выделенной памятью. Эта операция заняла O(n) времени. Исходя из этого, можно сделать вывод, что в худшем случае сложность вставки в динамический массив O(n), но это происходит не так часто, и в основном скорость вставки занимает O(1).
Получается, каждый раз делая .append(obj) в вашем коде, вставка может занимать как мгновение, так и достаточно долгое время, если список уже имеет большое количество элементов.
Вставка в произвольное место - O(n)
Со вставкой в произвольное место всё просто: нам нужно переместить все элементы с права от места, куда хотим вставить новый элемент на один вправо.
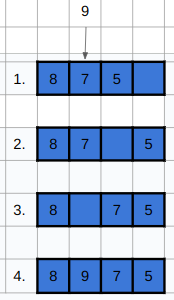
Точно так же, как и при поиске по значению, если перебрать все варианты вставок, то в среднем нам понадобится T(n * 0.5) операций, но в рамках асимптотической сложности это будет O(n).
Итог: List в python это гетерогенный(через ссылки), динамический массив.
Те, кому предоставленной информации оказалось мало, предлагаю в рамках эксперимента поступить так: вдобавок к вашей реакции в целом от статьи, ставить дополнительную реакцию ➕. Я уже добавил её в возможные реакции:
В зависимости от количества этих самых ➕ я буду понимать, насколько востребовано углубление в ту или иную тему.