Matching или как среди миллионов товаров найти одинаковые (быстро)
Ishutov NikitaЭта и другие статьи про рекомендации в Wildberries выходят в рамках телеграм канала @wildrecsys
Введение
Привет! Меня зовут Ишутов Никита и в этой статье я расскажу как наша команда разрабатывает метчинг для Wildberries.
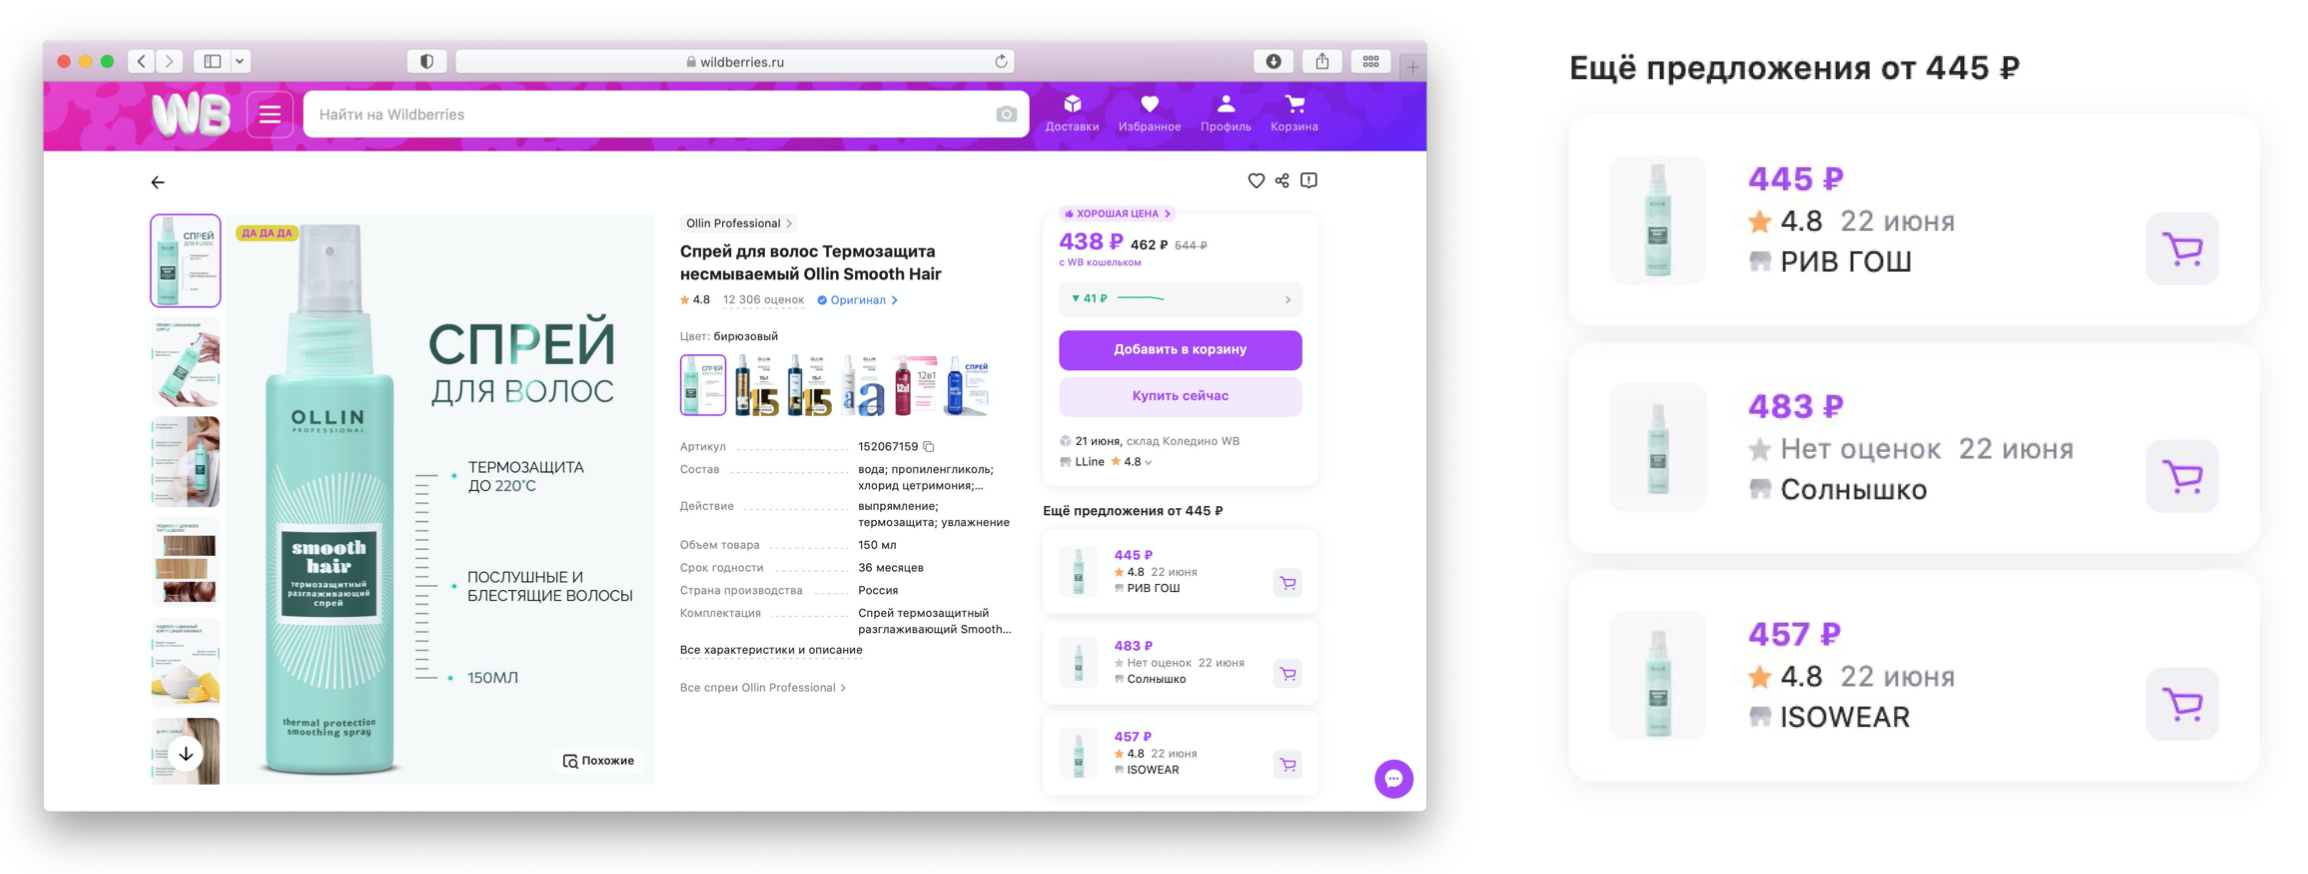
После выбора определенного товара, у пользователя может возникнуть потребность сравнить цену/количество отзывов/сроки доставки относительно других предложений. Такой запрос покрывает наш блок, экономя драгоценное время.
Информация полезна и нашим пользователям, и коллегам отдела рекомендаций, которые также активно используют информацию об одинаковых товарах для решения задач.
Какой план действий?
Есть стандрартный пайплайн для решения этой задачи, состоящий из двух-этапной модели:
- KNN
- Gradient Boosting
Мы же пришли к горизонтально масштабируемому пайплайну из трех-этапной модели и nearline рассчету.
- ANN
- Two-Tower Neural Network
- Community Detection
Но обо всем по порядку
Первый этап. Поиск кандидатов
У нас имеются десятки миллионов эмбеддингов, по которым необходимо определять близость. Важно максимально сократить время обработки запросов и обеспечить регулярное обновление индекса, чтобы включать свежие данные о товарах и поддерживать высокое качество поиска, учитывая всю доступную информацию.
Просто используем один из ANN инструментов?
И да и нет. Тривиальные решения приводят к ботлнекам в виде чтения/записи/обновления, а это все - время.
Давайте сформулируем более четкие требования:
- Быстро пересчитывать индекс для поиска - повышаем точность
- Быстрый доступ до самих эмбеддингов
- Оптимальное хранение
Для решения этих задач мы написали свою структуру для оперирования эмбеддингами с помощью mmap и поиском с помощью faiss, выбранным для ANN.
Сам поиск разбит на части и выполняется параллельно, что прибавляет в горизонтальной масштабируемости и скорости.
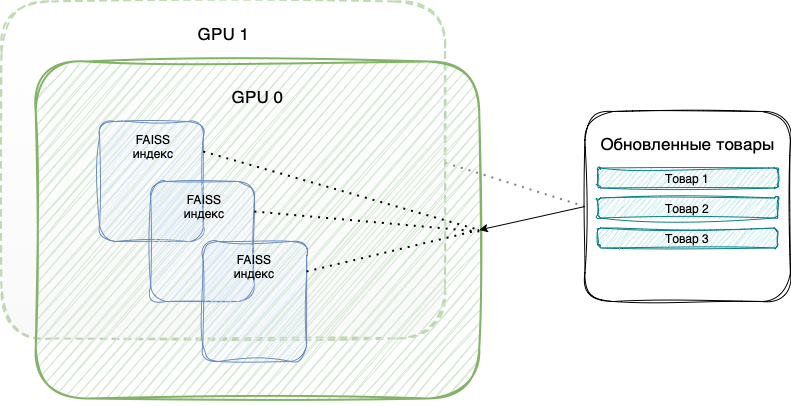
После ряда экспериментов мы получили для себя оптимальное решения по всем трем пунктам и готовы приступать к самому главному, модели точности.
Второй этап. Модель точности
На этом этапе нужно решить задачу классификации, уточнить пары, полученные после отбора кандидатов.
Раньше мы использовали градиентный бустинг. Экспериментируя с форматом мы пришли к нейросети, которая обеспечивает универсальность и ускоряет наш расчет.
Как раз для данного этапа нам нужен быстрый доступ к эмбеддингам, ведь на вход модели мы подаем лишь представления товара.
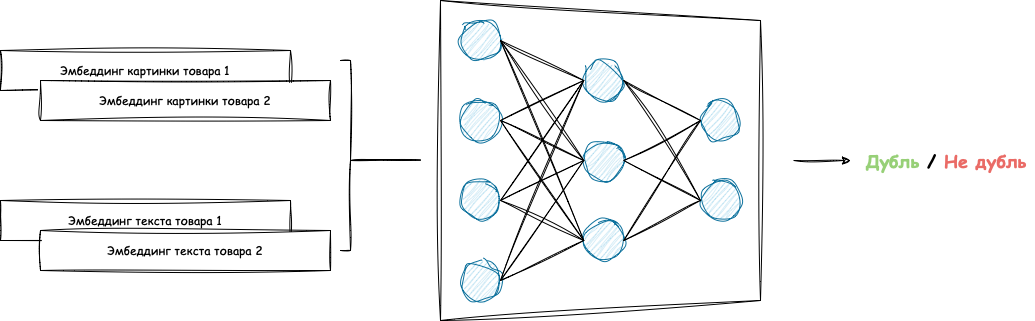
Идея хорошая и перспективная, давайте научим нейросеть вычленять нужную информацию из эмбеддингов пары товаров, с условием что сами эмбеддинги достаточно хороши для нашей задачи, но как избежать переобучения, как добиться хорошей точности?
Аугментация
Немного покопавшись в данных мы обнаружим что у максимально похожих, но все же разных товаров текстовые данные сильно схожи. Поставщики могут по своему заполнять характеристики, пренебрегая общим паттерном, копировать друг у друга описания и тд.
Давайте научим нейросеть больше обращать внимание на информацию картинок, используя аугментацию для текстовых представлений. Чтобы модель была готова работать с отсутствующим описанием, некорректно заполненными полями и подобными ситуациями.
Негативное семплирование
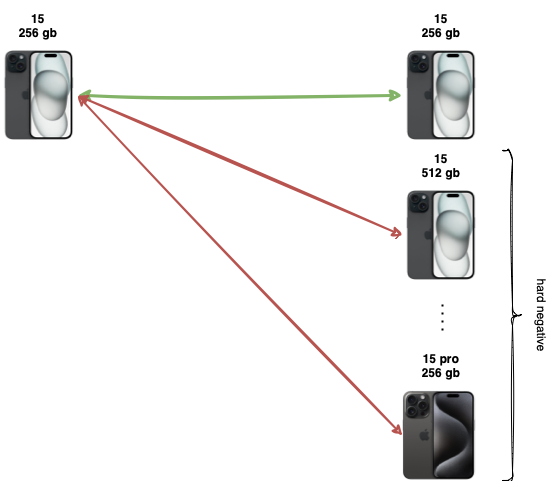
Так как, по сути, мы решаем достаточно большой мультилейбл, для этого нам понадобиться негативное семплирование. Давайте научимся находить хорошие hard-negatives для каждого позитивного примера. И действительно, работа в этом направлении дала свои плоды, качество заметно улучшилось.
Обучение под каждую категорию
Специфика заполнения карточек и обработки фото могут отличаться от категории к категории, поэтому логично обучать модель под каждую категорию. И действительно это тоже повлияло на качество модели
В результате мы получили нейросеть с отличным качествам, которая не зависит от определенного количество фичей и требует только эмбеддинги товара.
Что это нам дало?
Новое решение, описанное выше, дало сильный прирост по нашим основным метрикам:
- Скорость - товар только появился на wb, а мы уже ищем для него метчи
- Увеличение покрытия/универсальность - нам не важно заполнил продавец все характеристики или нет, мы сможет работать с любыми карточками
- Повышение точности - после работ, проведенных с моделью точности, качество матчей значительно увеличилось
Продолжение следует...
Мы научились быстро находить пары с хорошей точностью, далее было бы хорошо научиться объединять пары в непересекающиеся множества, где каждое множество является товаром. Сделать это можно с помощью Community Detection, а как именно, я расскажу в следующем посте