Агрегация и композиция(ассоциация)
KarmanovichDevПервая часть - https://telegra.ph/Agregaciya-i-kompoziciyaassociaciya-03-21
Плюсы/минусы композиции и агрегации:
Первые два пункта относятся к обоим видам связи и являются для них как плюсами, так и минусами. Всё зависит от контекста и ситуации, где вы используете эти виды связи. В одном месте контроль жизненного цикла полностью обоснован, в то время как в другом усложняет код, нарушает Solid(SRP), наделяет объект лишними знаниями, усложняет тестирование и т. д.
- (+/-)Создание тесной связи между объектами.
- (+/-)Возможность контролировать жизненный цикл
Если коротко, композиция может быть заменой наследованию, и/или возможностью создать между объектами тесную связь, тем самым улучшив сцепление(high cohesion). Агрегация же, помогает:
- Снять ответственность с кода за инстанцирование зависимостей(не быть фабриками для зависимостей. Чаще всего это лишние знания для объекта)
- Сделать бизнес логику не зависимой от деталей реализации, требуемых ей для работы механизмов(если добавить soliD)
- Упростить модульное(юнит) тестирование(даёт возможность внедрять снаружи подставные объекты и не делать Mock(s), Patch(s))
Хочу показать пример, как агрегация помогает писать модульные(юнит) тесты, изолируя код тестируемого объекта от его зависимостей:
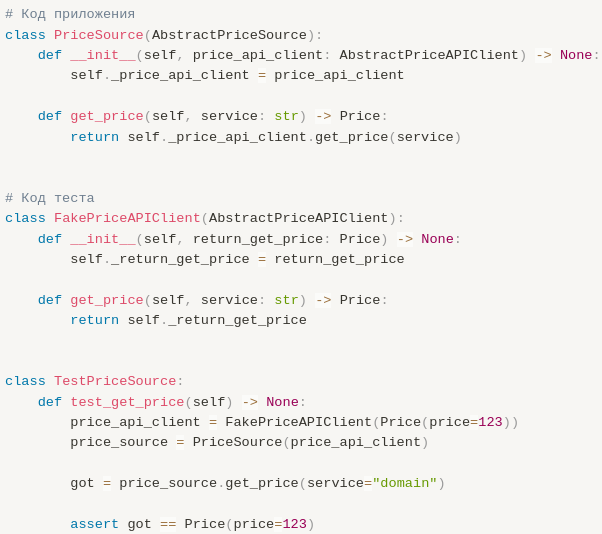
Мы создали тестовый дублёр для PriceAPICLient(FakePriceAPIClient). Он повторяет интерфейс требуемого объекта и в тесте заменяет его собой, чтобы вернуть заранее определённый ответ. Это даёт возможность не выполнять код API клиента, тем самым изолировав наш тест от зависимости.
Так же хочу показать, как агрегация, через инверсию зависимостей помогает держать наш бизнес код-чистым:
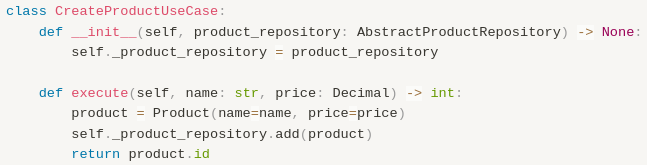
Из-за зависимости на абстракцию бизнес код ничего не знает о деталях реализации его зависимостей(будь там репозиторий, работающий с СУБД или через API с другим сервисом, или подставной объект внедрённый при тестировании).
В идеале новые объекты(зависимости) в вашем коде должны появляться так - какому-то объекту для работы понадобилось сделать некое действие которое, не входит в его ответственность, и тогда возникает вопрос: кому эту ответственность назначить?
В данном примере сценарию использования приложения(CreateProductUseCase) нужно сохранить продукт. Должна ли бизнес-логика знать, как сохранить продукт в базу или как отправить его по сети? Конечно же, нет! Эти знания инфраструктуры должны быть спрятаны от бизнес-логики и переданы в новый механизм, который будет отвечать за конкретную реализацию.
Хорошим вариантом для этого является паттерн репозиторий(инкапсулирует знания о хранении данных, и обычно выступает в роли коллекции элементов). Но если в нашем сценарии использования мы будем ждать снаружи ProductRepository, мы решим только проблему, что бизнес-код не будет сам ходить в базу или по API, но он всё ещё будет знать о конкретной реализации репозитория, который делает это, и импортировать его. А значит, всё ещё будет знать об инфраструктуре.
Решение довольно простое - сценарий использования объявляет требуемый ему интерфейс для работы, а каждый конкретный репозиторий должен реализовать его(Инверсия зависимостей(DI)).
И тогда ваш бизнес-код, будет знать лишь о том, что придёт "кто-то" но этот "кто-то" будет уметь делать нужные ему вещи.