Sona - разбор техрепорта
Ivan VashchenkoЯндекс Музыка представила Sona - модель поверхности "Моя Волна", которая успешно заменила собой связку кандидатогенерации и ранжирования. Приросты более чем серьезные: активные пользователи +4.53%, время прослушивания +6.30%, лайки +11.42% (Sona Technical Report).
Sona сама генерирует кандидатов и сама же их ранжирует, но у сгенерированных треков нет ни клика, ни скипа - пользователь их не видел, размечать нечем. Поэтому на обучении рядом стоит большая модель-учитель: она проставляет кандидатам скоры, а Sona учится повторять ее ответы. Учитель нужен только для таргетов и в прод не едет, поэтому ему по карману год логов, а Sona обходится недельными данными.
В статье сказано, что в контрольном проде работает каскад из трех стадий: полтора десятка моделей набирают кандидатов, pre-ranking режет их до нужного количества, ранкер на сотнях признаков дает конечное ранжирование. Каскад работает хорошо, проблема в том, что улучшать его можно только по кускам - у каждого этапа свое обучение и свои метрики, но чтобы существенно повысить метрики поверхности, надо менять все три сразу и следить, чтобы они были согласованными. Объединить кандидатогенерацию и ранжирование в одну модель пробуют давно, это общий тренд: UniPinRec у Pinterest, Gryphon у самого Яндекса. Полностью заменить ранкер там не вышло: у Pinterest в прод уехали retrieval и легкая ранжирующая голова, а тяжелый L2 остался прежним, у Gryphon финальный порядок тоже формировал старый ранкер.
Как устроена модель

Энкодер получает историю пользователя и превращает ее в представление, с которым дальше работают обе головы. Декодер по этому представлению генерирует кандидатов. Ранжирующая голова берет тех же кандидатов и выдает на каждого два скора, по которым строится финальный порядок.
Ручных фичей нет: ни категорий, ни счетчиков. Модель работает на semantic ID: каждому треку заранее присвоена тройка кодов. Собирают их офлайн в три шага:
- мультимодальная LLM обрабатывает mel-спектрограмму первых 90 секунд трека и читает его метаданные
- полученный вектор доводят на парах совместного прослушивания "два трека слушают вместе"
- RQ-KMeans режет пространство на три уровня кластеров, и номера кластеров становятся кодами-семантиками
Декодер генерирует семантик - каталожный индекс уже разворачивает его в список треков.
Sona - позиционируется как "облегченная" модель, но речь не про число параметров: сотни миллионов против 0.6B у учителя. "Легкая" она по ширине горизонта обучающих данных, а длина истории у обеих моделей одна и та же - 8192 события.
Также на схеме представлены два разных источника обучающего сигнала. Декодеру в NTP таргеты отдает Semantic Tokenizer, то есть коды тех треков, которые пользователь реально слушал. Ранжирующей голове таргеты отдает Teacher Ranker. Далее чуть подробнее об этом.
Подход с дистилляцией
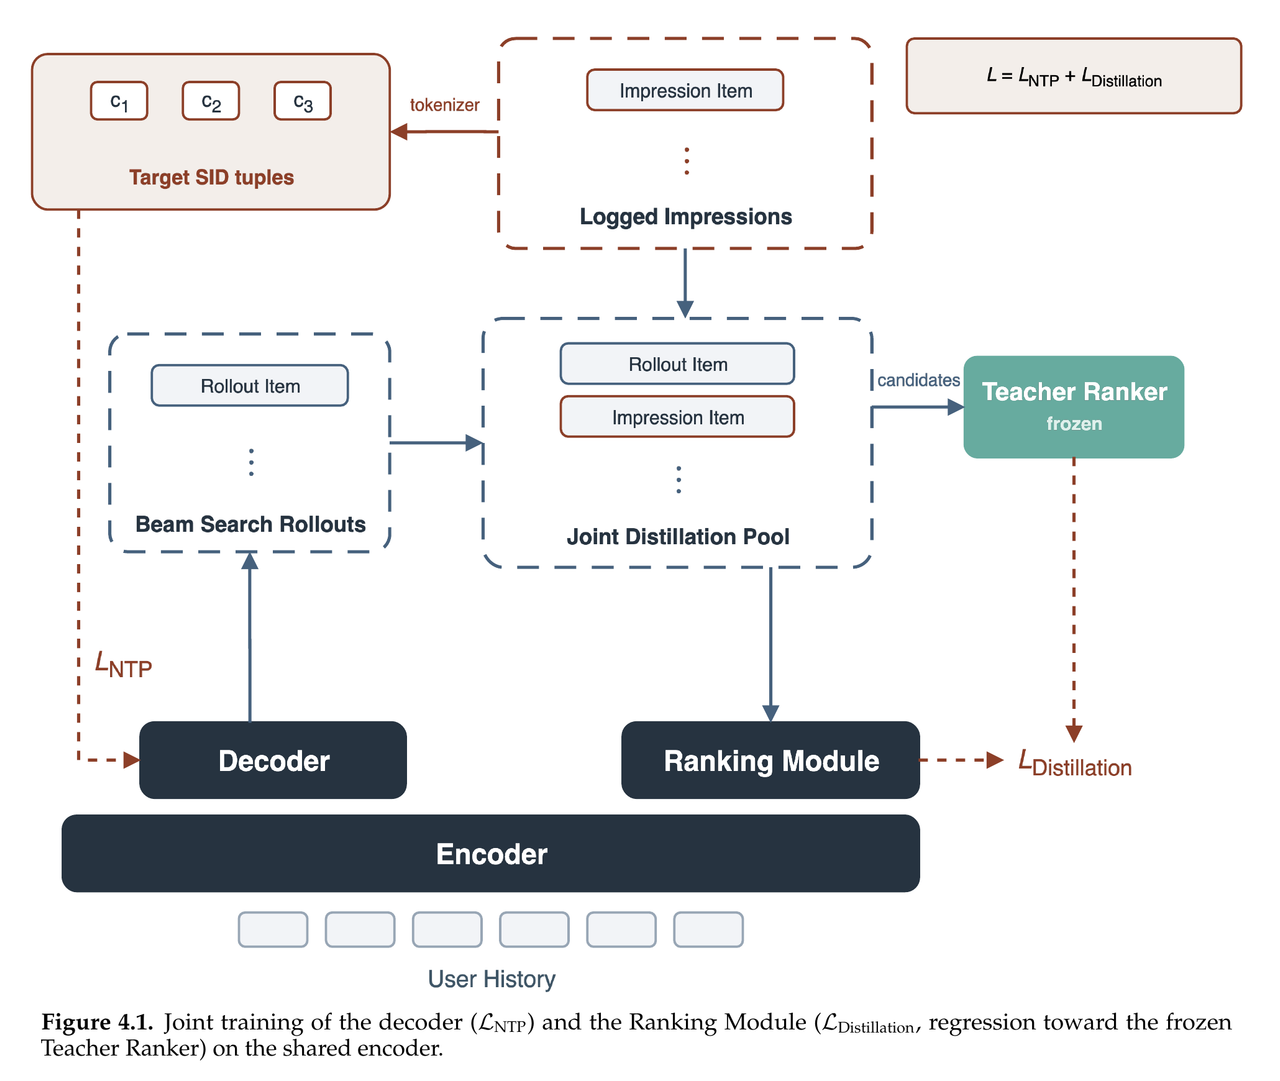
На схеме слева ветка декодера: позитивные показы переводятся в семантики, и декодер учится их предсказывать. Обычный next-item prediction.
В центре схемы пул для дистилляции, и он собран из двух источников. Первый - залогированные показы. Второй - роллауты: прямо во время обучения декодер генерирует через Beam Search 32 кода по этой же истории, и они разворачиваются в треки-айтемы. На инференсе beam шире, там набирается 1024 кода, но на обучении ширину держат маленькой: согласно выкладкам 128 чуть лучше 32, но вчетверо дороже по скорингу, и авторы осознанно зафиксировали 32.
Роллауты нужны потому, что в проде ранжирующая часть будет сортировать кандидатов своего же декодера. Если учить ее только на показах, полнота отбора не страдает, а вот качество ранжирования падает. Роллауты же несут за собой далее ключевую проблему. Пользователь этих треков не видел, взаимодействий по ним нет, и таргет для ранжирования взять неоткуда. Если взаимодействие все-таки есть, значит трек просто совпал с показом.
Справа на схеме ответ - замороженный учитель. Он скорит весь пул целиком, и показы, и роллауты, а Sona решает задачу регрессии (по сути дистилляция) на эти значения. Вместо того чтобы учить задачу с нуля на разреженной разметке, маленькая модель предсказывает скор большой модели.
Лосс в итоге складывается из трех слагаемых с равными весами:
- next-item по семантикам у декодера
- регрессия на скоры учителя по роллаутам
- такая же регрессия по логированным показам.
Градиенты всех трех текут в общий энкодер, поэтому генерация и ранжирование тянут одно и то же представление истории. Абляции по составу лосса авторы гоняли в офлайне, и там видно, что убирать слагаемые нельзя: без роллаутов разваливается сортировка, без next-item декодеру не на чем учиться.
Внутреннее устройство Teacher Ranker
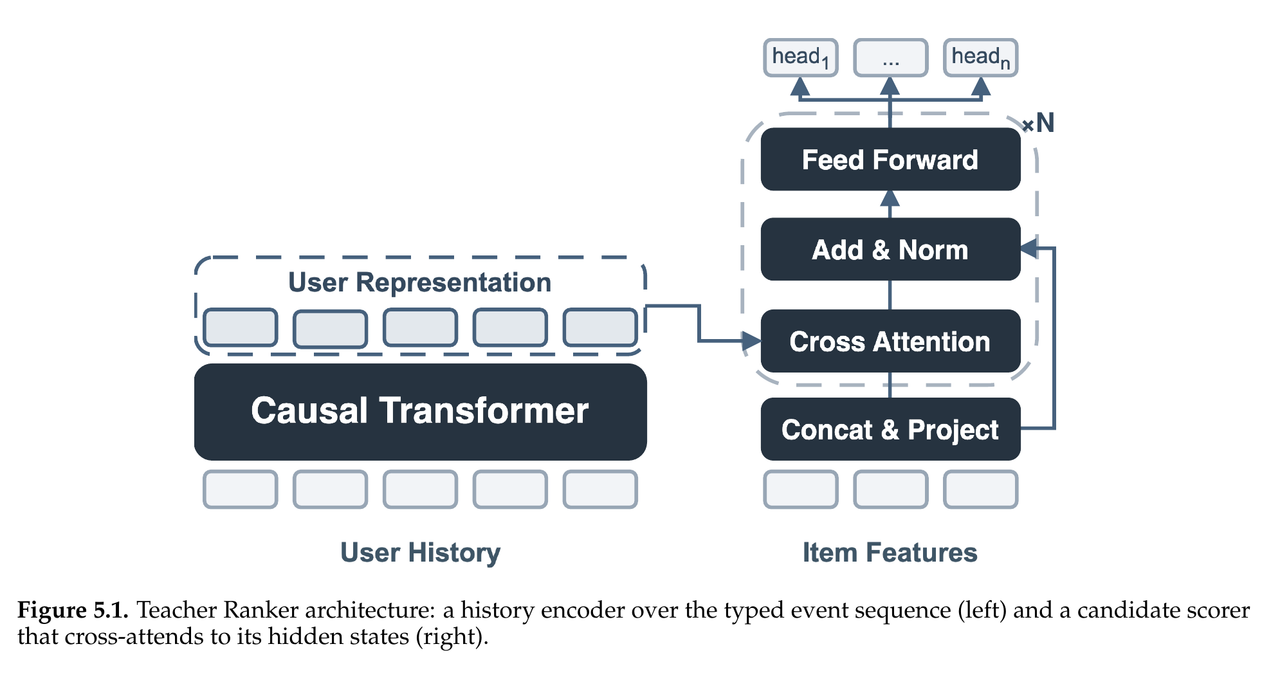
Когда модель учится предсказывать next-item, один проход дает прогноз в каждой точке последовательности сразу. С ранжированием так не выйдет. Надо получить состояние пользователя на момент запроса, наложить его на группу кандидатов с позитивом и негативами и посчитать лосс по этой группе. Один проход обслуживает одну группу, то есть один запрос. Чтобы обучить ранжирование на годовом промежутке, историю пришлось бы прогонять заново на каждый запрос этого года, и это не влезает в эффективную конфигурацию - что-то обязательно просядет: либо длина истории, либо объем данных.
Teacher Ranker обходит это устройством, которое видно на схеме. Causal encoder рассчитывает состояние пользователя на каждый момент времени. Справа - скоринг кандидатов, который к этому состоянию обращается. Показ из марта скорится против мартовского состояния, показ из июля против июльского, и все внутри одного forward pass. Так год данных и умещается в разумный бюджет, а потом этот годовой опыт переносят в Sona через скоры.
Обучают учителя в три стадии по рецепту Argus: претрейн на предсказание следующего взаимодействия, файнтюнинг на ранжирование по градуированной шкале like > play > skip > dislike и ежедневный refresh на свежих логах. Компрессий у него нет, attention полный на всю историю - деплоить модель не требуется, поэтому и экономии какой-либо не нужно.
Внутреннее устройство Sona
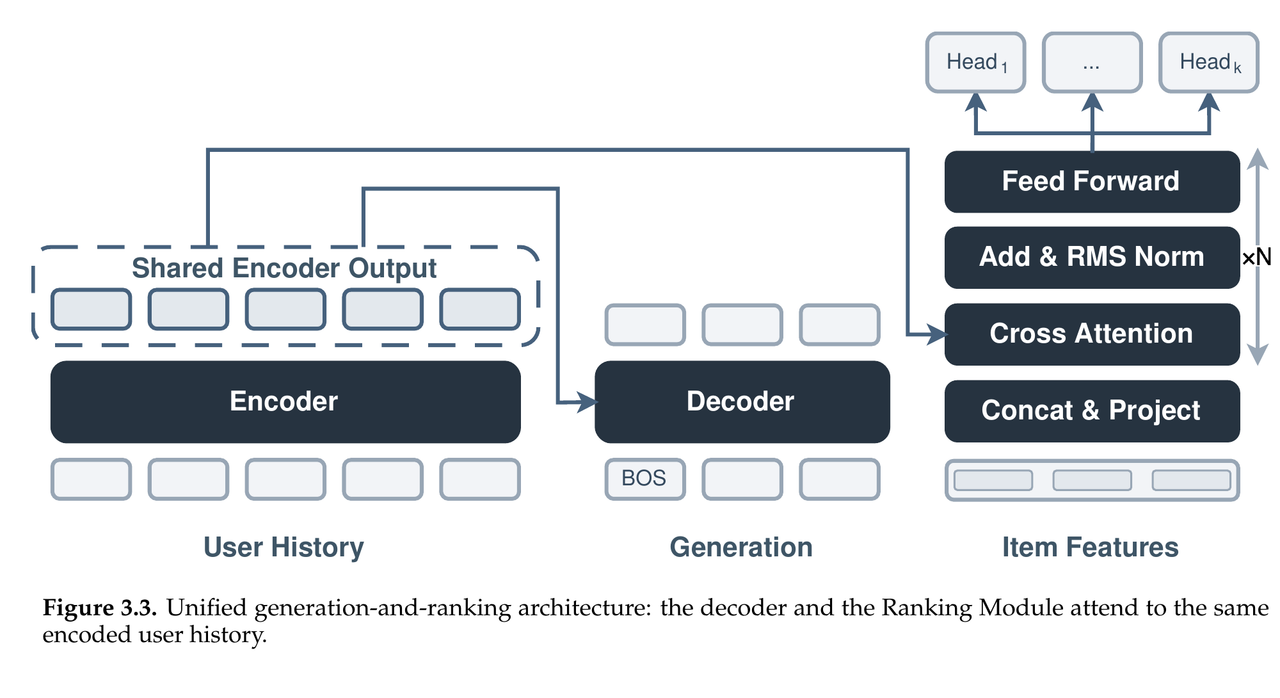
Дальше речь пойдет про энкодер самой Sona: энкодер истории есть и у Teacher Ranker, но устроены они по-разному - у учителя causal, у Sona с компрессией. С векторами энкодера Sona работают обе ее головы: декодер прогнозирует по ним семантики кандидатов, а ранжирующая голова "оценивает" каждого кандидата. Оценка идет через cross-attention: эмбеддинг кандидата подается как query, векторы истории как key и value, на выходе два числа - те самые скоры, которые голова дистиллирует за учителем. Судя по описанию экспериментов, видимо один определяет что-то похожее на вероятность позитивного события, второй прогнозирует тип действия, точного состава авторы не называют. Схема скоринга тут и правда такая же, как у Teacher Ranker: ранжирующую голову Sona собрали по образцу, только мельче - четыре attention блока против шести.
Ранжировать прямо по выходу декодера кстати не получится. Beam Search выдает семантики по убыванию правдоподобия, но правдоподобие посчитано для семантика целиком, а за одним семантиком стоит сразу несколько треков, и внутри этой группы оценка у всех одинаковая. Ранжирующая голова работает с эмбеддингом конкретного трека, поэтому различает их. Разрыв авторы измеряют тем, насколько топ-10 модели совпадает с топ-10 учителя на одном и том же пуле: сортировка по правдоподобию декодера дает в 10 раз хуже качество по офлайн-замерам.
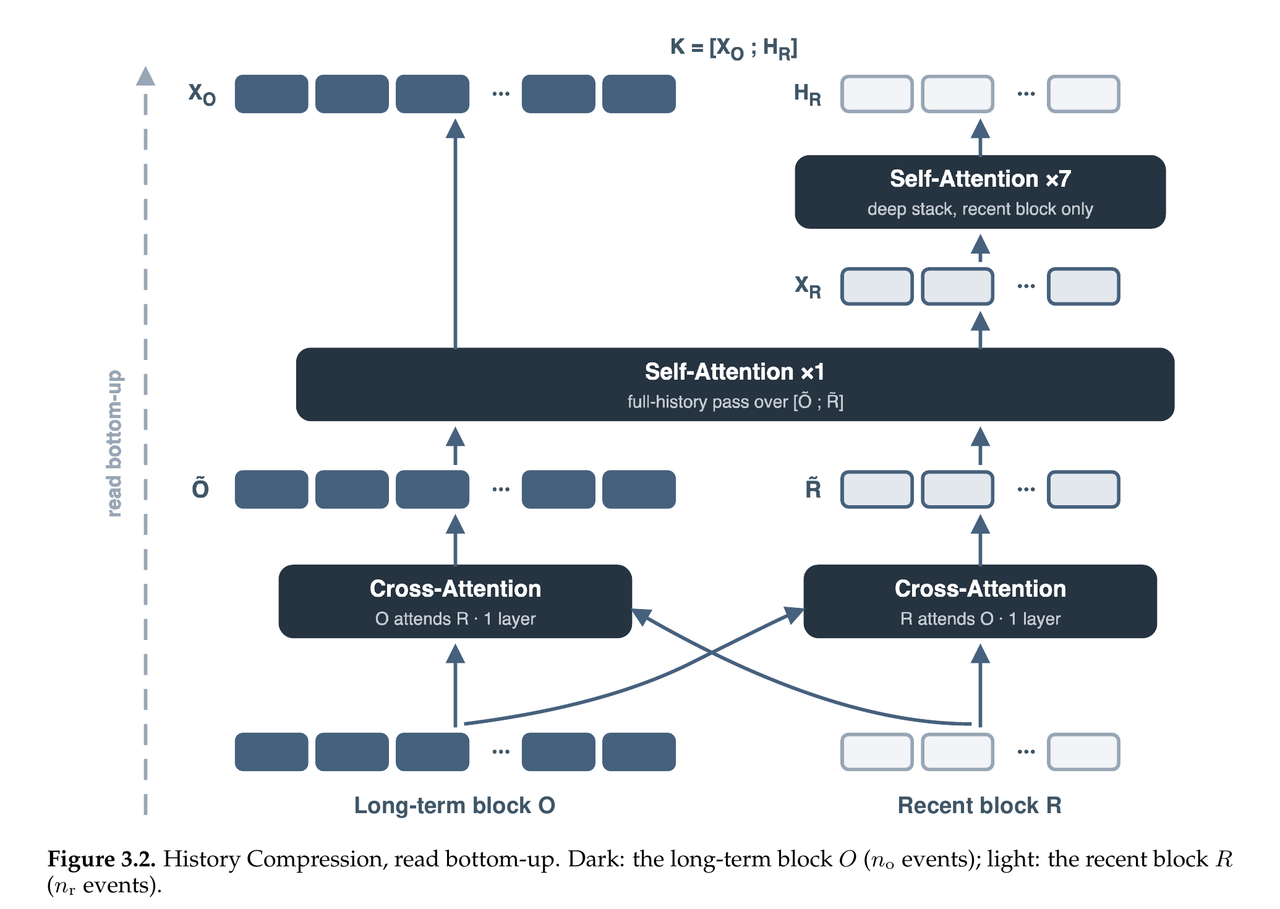
Sona это runtime модель, и при длине последовательности 8192 полный self-attention становится накладным. Частично удалось сэкономить на том, что "глубина" нужна не для всех событий: свежие треки в последовательности могут отвечать на вопрос "что играть прямо сейчас", а ранние больше работают общим контекстом. Поэтому слои распределены неравномерно:
- один слой self-attention проходит по всем 8192 позициям
- глубокий стек attention blocks обрабатывает лишь последние 2048 событий
- еще два слоя держат связь между блоками, свежий читает ранний и наоборот.
На выходе оба куска склеиваются, и обе головы дальше читают все 8192 позиции. По вычислениям выходит примерно вдвое дешевле полного энкодера, а качество почти не меняется: recall чуть ниже, WPA даже чуть выше.
Про инференс на проде
Деплоится одна модель - объединение энкодера, декодера и ранжирующей головы. Semantic Tokenizer и Teacher Ranker в прод не идут, от токенизатора остается только детерминированный индекс "семантик -> треки".
В момент запроса декодер набирает через beam search 1024 семантика, индекс разворачивает их в пул треков, ранжирующий модуль скорит пул, и два ее скора сводятся в один взвешенной суммой. Веса этой суммы живут только на инфре и ни в какой лосс не входят, поэтому баланс лайков и времени может меняться без переобучения.
Инпут собирает отдельный CPU-сервис: читает профиль и раскладывает события истории по атрибутам - что за трек, где слушали, как отреагировали. Каких-либо ручных фичей тут по-прежнему нет, собираются только поля самих событий. Профиль лежит в двух хранилищах - батчевое с полной историей на 8192 события, которое пересобирается периодически и слегка отстает, и потоковое за последние 72 часа. На чтении их склеивают, держать полный профиль горячим на каждый запрос дорого.
Дообучение в онлайне
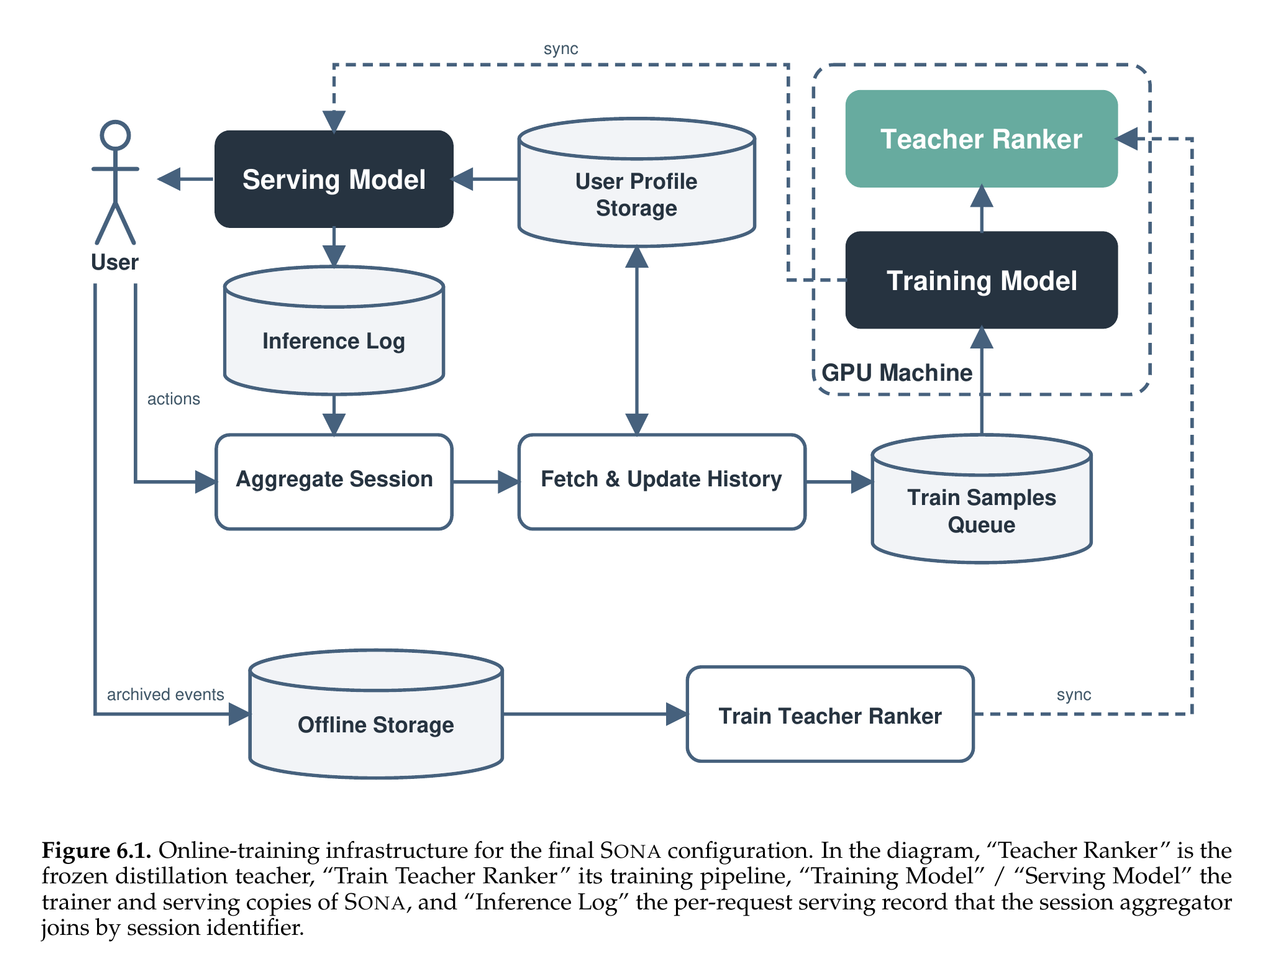
Обычно рекомендательную модель переобучают в офлайне - раз в сутки или реже. Sona дообучается непрерывно: параллельно с продом крутится трейнер, который учит копию модели на потоке свежих событий и регулярно выкладывает новые веса. В рекомендациях так делают мало где, а для потоковой музыки это оправдано, потому что реакция на трек приходит в первые секунды.
Цикл на схеме замкнут: отдается некоторая выдача, события пользователя по ней возвращаются в обучение, трейнер катит новые веса обратно на сервис. Собираются события в сессии, причем сессия закрывается не сразу - дается окно атрибуции минут в пятнадцать, чтобы успел долететь поздний фидбек. По дороге отсекается фрод, боты, слишком короткие истории и трафик экспериментальных моделей.
Дальше GPU-трейнер обрабатывает эту очередь и каждые 10 минут выкладывает новый checkpoint, который подхватывает сервинг. Teacher Ranker живет отдельным циклом и обновляется раз в сутки, ему такая скорость не нужна. В итоге от события пользователя до модели, которая это событие уже видела, проходит в медиане 45 минут.
АБ результаты
Экспериментов было проведено пять, каждый проверял один следующий шаг улучшения модели, все дельты против прод-контроля с кандидатными источниками и отдельным ранкером.
Сначала проверили сам Teacher Ranker. На продовых кандидатах он дает +1.64% времени и +1.22% активных пользователей против старого ранкера, а вместе с энкодером и декодером вместо всего стека - +3.63% и +2.72%.
Потом проверили дистилляцию на одних и тех же кандидатах от декодера Sona. В первой ветке сортирует ее собственная ранжирующая голова, обученная на скоры Teacher Ranker: +1.62% времени, +7.12% лайков и +1.41% активных пользователей, и это уже полноценная замена каскада. Во второй те же кандидаты сортирует сам Teacher Ranker, поднятый на сервинг: +4.32% времени. То есть голова дистилляции до учителя не дотягивает, что логично.
Если сложить шаги, получается такая картина - авторы ее не проводят, это уже моя интерпретация. Замена старого ранкера на трансформер без фичей дает около полутора процентов времени. Замена кандидатогенерации добавляет примерно столько же: связка энкодер-декодер с учителем поверх выходит уже на +3.63%. А финальные +6.30% появляются только в полной конфигурации, где у Sona длинная история на 8192 события вместо 2048. То есть вытянул не один какой-то модуль, а сумма двух вещей: годовой горизонт, зашитый в Teacher Ranker, и длинный контекст у самой Sona. Сама по себе дистилляция качества не добавляет, она переносит его в модель, которую можно держать в проде.
Некоторые вопросы все же остались, и их стоит держать в голове. Например - покрытие каталога. У Sona оно ниже, чем у старого стека, и авторы это признают сами, но метрик по explore не приводят. Для музыки, где есть длинный хвост и постоянно появляются новые артисты, это возможный долгосрочный риск, который в АБ и тяжело измерить из-за его временной ограниченности. Также нет чистого сравнения с Teacher Ranker. В АБ студента сравнивали с учителем поверх тех же кандидатов, но у студента там история 2048 событий против 8192 у учителя, поэтому зазор между +1.62% и +4.32% нельзя списать на одну дистилляцию. Сколько качества теряется именно на копировании скоров, из репорта возможно я просто не понял.


Заключение
Работа говорит сама за себя, и лично от себя я мало что могу тут добавить. В общем и целом - изящное решение по честному объединению всех стадий пайплайна рекомендаций в одной модели. Нет сомнений, что была проделана колоссальная работа по подбору работающей конфигурации, прежде чем она начала давать осмысленные приросты хотя бы в офлайне (о чем и пишут). Уверен данная концепция с дистиллированием - лишь начало, которое за еще один год может обрасти новыми фишками и особенностями.
Отдельно любопытно, где у такой схемы потолок. Sona по построению не может стать лучше учителя: она копирует его скоры, значит и упирается в его качество. Сами авторы в планах пишут про RL-постобучение на реальном фидбеке, и наверное это логичное продолжение - когда supervised выжат досуха, расти дальше можно только за счет сигнала, которого у учителя нет.