Seccomp, Seccomp и syscall'ы: BSidesSF и seccomp в Kubernetes
Практические угрозы: от чего мы пытаемся защититься?
Раньше было сложно объяснить людям все причины, по которым им нужно защищать свой кластер. Мы придумывали натянутые примеры разных путей эксплуатации внутри Kubernetes, но до недавнего времени самой вероятной атакой были скучные старые криптомайнеры.
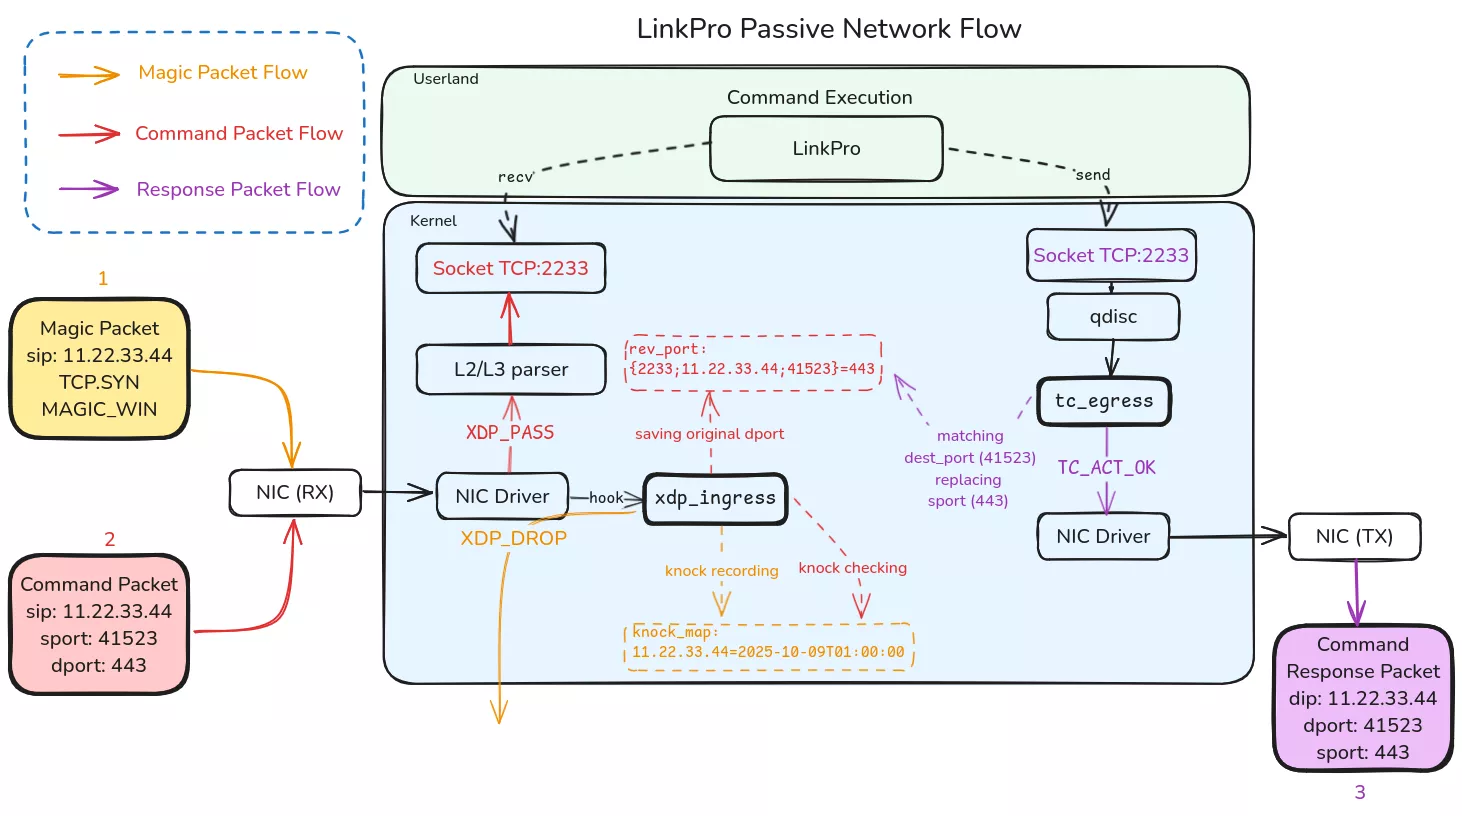
Всё изменилось. Атакующие эволюционировали. Можете посмотреть на LinksPro как на пример руткита на eBPF, рассчитанного на компрометацию даже контейнерных окружений. Или ещё актуальнее прямо сейчас, TeamPCP - угроза момента, которая прямо сейчас активно целится в кластеры Kubernetes, разворачивает привилегированные DaemonSet'ы, чтобы перемещаться по окружениям и вытягивать секреты.
Но можно и проще: у нас куча агентных workload'ов и окружений для разработки AI, которые хочется запесочить. Конечно, Kubernetes всплывёт как решение. И конечно, им нужны гарантии изоляции покрепче, чем просто контейнер.
Есть сетапы на microVM вроде firecracker или эмулированные ядра вроде gVisor. Это отличные решения, и они работают. Сходите посмотрите. Сегодня поговорим про Seccomp.
Seccomp: инструмент, за который хватаются все
Мне не нужно рассказывать вам историю Seccomp, потому что думать о Seccomp глубже, чем "это allow/deny-список системных вызовов (с некоторыми дополнительными фичами)", нам не надо. Но самый частый вопрос, который мне задают, когда разговор заходит про seccomp и контейнеры: "Почему seccomp вообще оказался в контейнерах?" Могу объяснить, показав вам рекомендуемый способ делать seccomp нативно в программе на Go:
package main

import (
    "fmt"
    "os"

    // Импортируем модуль libseccomp
    libseccomp "github.com/seccomp/libseccomp-golang"
)

func main() {
    // Создаём новый seccomp-фильтр, который по умолчанию запрещает все syscall'ы
    filter, err := libseccomp.NewFilter(libseccomp.ActErrno.SetReturnCode(int16(1)))
    if err != nil {
        fmt.Fprintf(os.Stderr, "failed to create seccomp filter: %v\n", err)
        os.Exit(1)
    }
    defer filter.Release()

    // Разрешаем только те syscall'ы, которые нам реально нужны
    allowed := []string{
        "read", "write", "open", "close", "stat", "fstat",
        "mmap", "mprotect", "munmap", "brk", "rt_sigaction",
        "rt_sigprocmask", "exit", "exit_group",
    }

    // Компилируем это в байткод seccomp-bpf
    for _, sc := range allowed {
        syscallID, err := libseccomp.GetSyscallFromName(sc)
        if err != nil {
            fmt.Fprintf(os.Stderr, "unknown syscall %s: %v\n", sc, err)
            os.Exit(1)
        }
        if err := filter.AddRule(syscallID, libseccomp.ActAllow); err != nil {
            fmt.Fprintf(os.Stderr, "failed to allow %s: %v\n", sc, err)
            os.Exit(1)
        }
    }

    // Загружаем фильтр в ядро - с этого момента мы заперты
    if err := filter.Load(); err != nil {
        fmt.Fprintf(os.Stderr, "failed to load seccomp filter: %v\n", err)
        os.Exit(1)
    }

    fmt.Println("running under seccomp")
    // ... остальная логика приложения
}
Запускаете программу, импортируете seccomp, генерируете фильтр, применяете его к себе и дальше запускаете остальную программу. Для большинства разработчиков, которые не эксперты по ядру Linux и не тратят кучу времени на харденинг своих приложений, это уже перебор.
Когда появился Docker, они кое-что поняли про seccomp: каждый контейнеризованный процесс стартует из другого родительского процесса, а что, если назначать seccomp-профиль родительскому процессу, а не основному приложению? Это дало бы стандартный способ делать seccomp, даже ничего не зная о приложении внутри.
docker (CLI)
└─ dockerd
   └─ containerd
      └─ containerd-shim-runc-v2
         └─ runc init   << профиль seccomp
            └─ entrypoint
Потом приходит Docker и говорит:
Эй, знаете, чего не хватает seccomp? JSON
{
  "defaultAction": "SCMP_ACT_ALLOW",
  "architectures": [
    "SCMP_ARCH_X86_64",
    "SCMP_ARCH_X86",
    "SCMP_ARCH_X32"
  ],
  "syscalls": [
    {
      "names": [
        "mkdir",
        "mkdirat"
      ],
      "action": "SCMP_ACT_ERRNO"
    }
  ]
}
И именно поэтому вы можете сделать docker run --security-opt seccomp=/path/to/seccomp_profile.json
А потом приходит Kubernetes и говорит:
Эй, знаете, чего не хватает этому seccomp json? YAML
apiVersion: security-profiles-operator.x-k8s.io/v1beta1
kind: SeccompProfile
metadata:
  namespace: default
  name: mkdir-violation
spec:
  defaultAction: SCMP_ACT_ALLOW
  syscalls:
    - action: SCMP_ACT_ERRNO
      names:
        - mkdir
Так что теперь, если вы используете что-то вроде Security Profiles Operator, можно грузить seccomp-профили как нативный объект k8s. Отлично. И как нам теперь этим пользоваться?
Почему с этой хернёй так сложно
Я разбиваю это на три дополнительных поста, потому что тема не из простых. Здесь короткий обзор, а дальше сами решайте, хотите ли подробности по каждому разделу, если не хотите, то следующие несколько постов можно будет пропустить :).
Впереди нас ждут следующие разделы:
- Собираем небезопасные и неполные профили
- Обходы и побеги
- Измерения, оценки и масштабирование
Сквозная тема тут: измерять эффективность ваших seccomp-профилей сложно, и бесчисленного количества инструментов для этого пока нет.
Почему это вообще важно?
Всем, кто сегодня занимается безопасностью Kubernetes, оказывают медвежью услугу, когда туманно говорят: используйте seccomp. Одно и то же слышно постоянно: в кластере надо собрать seccomp-профиль на каждый workload, и это его захарденит. Обычный ответ на такое - "Удачи!"
Дальше развилка.
1. Если вы уже делаете всю работу, чтобы seccomp у вас был настроен правильно, этот труд стоит признать. Он не из лёгких.
2. Если вы только присматриваетесь к seccomp в Kubernetes и ждёте, что он закроет все проблемы, тут стоит испугаться. До усрачки.
Главная цель этого цикла статей, чтобы вы после всего прочитанного не остались посередине, с прохладным отношением к Seccomp в K8s.