Rust как часть микросервисной архитектуры
Бэкендер
Как использовать Rust в веб-приложении полного цикла? В этой статье расскажем об альтернативном способе включения Rust в приложение.
В целом можно сказать, что самые очевидные преимущества Rust — это скорость решения задач, интенсивно расходующих ресурсы процессора, и очень эффективная работа с памятью (причем без сборщика мусора).
Но есть небольшой недостаток — очень строгая модель владения. Впрочем, не такой уж это и недостаток: если ее придерживаться, получается очень стабильный и легкий в сопровождении код.
Однако бывают случаи, когда скорость разработки — важный фактор проекта. Тут в первую очередь желательно разделить приложение на несколько частей и для каждой использовать наиболее подходящий язык. Как это реализовать? Одно из решений — применение микросервисной архитектуры. Его и рассмотрим.
Для понимания содержания этой статьи необходимы базовые знания Rust и TypeScript.
Общая цель
В качестве простого примера реализуем вместе 3 микросервиса.
- main-server с общедоступным API и размещением небольшого клиента, построенного на Vue. Язык — TypeScript, и будем использовать популярный фреймворк NestJS.
- calc-engine — сервер Rust с методами для выполнения вычислений, интенсивно расходующих ресурсы процессора.
- rabbitmq — это брокер сообщений между двумя предыдущими сервисами, он поддерживается RabbitMQ.
Все это развернем в docker-compose — для совместного использования.
Опишем лишь самые важные части реализации. Весь код есть в репозитории — он только для образовательных целей.
Calc-engine (Rust)
В этой части — типичное бинарное приложение с применением cargo. Зависимости здесь такие:
amiquip = { version = "0.4.2", default-features = false }
serde_json = { version = "1.0.81" }
rayon = { version = "1.5.3" }
num_cpus = { version = "1.13.1" }
dotenv = { version = "0.15.0" }
Важная зависимость — amiquip, позволяющая взаимодействовать с RabbitMQ.
Чтобы создать приложение с как можно большим числом параллельных вычислений, применяется крейт rayon. Вот как с ним настраивается пул потоков:
fn setup_pool() -> rayon::ThreadPool {
    rayon::ThreadPoolBuilder::new()
        .num_threads(num_cpus::get())
        .build()
        .unwrap()
}
В задачах, интенсивно расходующих ресурсы процессора, запускать параллельно процессоры в добавок к имеющимся обычно не имеет смысла.
Подключаемся к RabbitMQ вот так:
fn setup_connection() -> Connection {
    if let Ok(c) = Connection::insecure_open(&format!(
        "amqp://{}:{}@{}:{}",
        env::var("RABBITMQ_USER").unwrap(),
        env::var("RABBITMQ_PWD").unwrap(),
        env::var("RABBITMQ_HOST").unwrap(),
        env::var("RABBITMQ_PORT").unwrap()
    )) {
        println!("Connected to rabbitmq!");
        c
    } else {
        println!("Failed to connect to rabbitmq. Will retry in 2s.");
        std::thread::sleep(std::time::Duration::from_secs(2));
        setup_connection()
    }
}
С ошибками подключения справляемся, принимая определенные значения из файла .env, а также переподключаясь каждые две секунды (2s). К настройкам микросервисов этот подход особенно применим, ведь каждый сервис после временного сбоя других сервисов должен восстанавливаться.
Стилем взаимодействия между сервисами будет RPC (remote-procedure-call, то есть «удаленный вызов процедур»). Такой выбор не всегда лучший, но для наших целей подходит.
Задачей, интенсивно расходующей ресурсы процессора, будет вычисление шагов решения головоломки «Ханойская башня». Отсюда этот «hanoi» в коде ниже:
fn setup_hanoi_queue(pool: &rayon::ThreadPool) {
    let mut connection = setup_connection();
    let channel = connection.open_channel(None).unwrap();
    let queue = channel
        .queue_declare("hanoi", QueueDeclareOptions::default())
        .unwrap();
    let consumer = queue.consume(ConsumerOptions::default()).unwrap();
    for message in consumer.receiver().iter() {
        match message {
            ConsumerMessage::Delivery(delivery) => {
                let body = String::from_utf8(delivery.body.clone()).unwrap();
                let (reply_to, correlation_id) = match (
                    delivery.properties.reply_to(),
                    delivery.properties.correlation_id(),
                ) {
                    (Some(r), Some(c)) => (r.clone(), c.clone()),
                    _ => {
                        println!("received delivery without reply_to or correlation_id");
                        continue;
                    }
                };
                let channel_for_msg = connection.open_channel(None).unwrap();
                pool.spawn(move || {
                    let exchange = Exchange::direct(&channel_for_msg);
                    exchange
                        .publish(Publish::with_properties(
                            json!(hanoi::hanoi(body.parse().unwrap(), 0, 2))
                                .to_string()
                                .as_bytes(),
                            reply_to,
                            AmqpProperties::default().with_correlation_id(correlation_id),
                        ))
                        .unwrap();
                });
                consumer.ack(delivery).unwrap();
            }
            other => {
                println!("Consumer ended: {:?}", other);
                println!("Will try to reset connection in 2s.");
                std::thread::sleep(std::time::Duration::from_secs(2));
                break;
            }
        }
    }
    setup_hanoi_queue(pool);
}
Здесь первым делом убеждаемся, что в RabbitMQ есть очередь с именем hanoi: открываем канал channel поверх соединения connection, а затем просто объявляем очередь queue для создания/потребления сообщений в сервисах.
Чтобы прослушать добавленное в queue сообщение, вызываем queue.receiver(). Это аналогично прослушиванию во внутренних каналах Rust, и код внутри блока выполняется сообщение за сообщением.
Каждое новое сообщение message должно сопоставляться с его типом. То есть, по сути, это либо ConsumerMessage::Delivery, либо ошибка подключения — с тем и другим разбираемся в other.
Кроме тела body, у сообщения есть два поля: reply_to и correlation_id. body — это фактическое содержимое (количество элементов в игре «Ханойская башня»), reply_to — «эксклюзивная» очередь для возвращения результата, а correlation_id применяется для сопоставления запроса с ответом.
Клиент, отправляющий сообщение в очередь hanoi, прикрепляет уникальное correlation_id. Это позволяет потом выбрать результат, записанный из сервера в очередь reply_to.
Чтобы обрабатывать параллельно как можно больше задач, расходующих ресурсы процессора, просто помещаем текущий запрос в замыкании в пул потоков. В каждом таком замыкании содержится логика для возвращения результата через очередь reply_to.
Отправка идет с помощью экземпляра Exchange::direct для канала channel_for_msg. А в other каждые две секунды (2s) просто переустанавливаются конструкции этого слушателя, благодаря чему ошибки подключения или перезапуски RabbitMQ не сказываются на сервисе.
Main server (TypeScript)
Прежде всего, Main server — это общедоступный API, позволяющий клиентам запрашивать шаги решения для игры «Ханойская башня»:
@Get('/hanoi')
getHello(@Query('n', ParseIntPipe) n: number): Promise<string> {
  ...
  return this.appService.makeHanoi(n);
}
Не знакомы с NestJS? Не проблема: это самый легкий в освоении веб-фреймворк, основные его концепции есть в этом простом обзоре.
В конечной точке метод makeHanoi делегируется и в итоге оказывается в методе MessageService.sendMessage. В этом сервисе содержится логика подключения к RabbitMQ, но теперь со стороны main-server:
async sendMessage(n: number): Promise<string> {
        const channel = await this.ensureChannel();
        const replyTo = await this.ensureResponseQueue(channel);
        const correlationId = this.generateUuid();
        channel.sendToQueue(
            this.HANOI_QUEUE,
            Buffer.from(`${n}`),
            {
                correlationId,
                replyTo
            });
        return lastValueFrom(
            this.queueResponse.pipe(
                filter(
                  m => m?.properties.correlationId === correlationId
                ),
                first(),
                map(m => m.content.toString())
            )
        );
}
Наши параметры сообщений — replyTo и correlationId — тут тоже есть. Мы на стороне создателя, поэтому эти значения здесь же создаются и прикрепляются к сообщению, отправляемому в очередь hanoi.
После отправки регистрируем одноразового слушателя в очереди, используемой в качестве replyTo. Если подробнее — эта последняя очередь потребляется внутренне для выдачи значений следующему BehaviorSubject:
private queueResponse = new BehaviorSubject<Message>(null);
В этом коде при первом соответствующем correlationId регистрируется подписка и с помощью оператора lastValueFrom преобразуется в Promise.
В основе здесь — популярная библиотека реактивного программирования rxjs.
Опуская подробности, кратко рассмотрим реализацию ensureChannel:
private async ensureChannel(): Promise<Channel> {
        return this.channel ?? this.creatingChannel.value ?
            lastValueFrom(this.creatingChannel.pipe(filter(v => !v), first(), map(() => this.channel))) :
            new Promise((res, rej) => {
                this.creatingChannel.next(true);
                const [host, user, pwd, port] = [
                    this.configService.get<string>('RABBITMQ_HOST'),
                    this.configService.get<string>('RABBITMQ_USER'),
                    this.configService.get<string>('RABBITMQ_PWD'),
                    this.configService.get<string>('RABBITMQ_PORT')
                ];
                connect(`amqp://${user}:${pwd}@${host}:${port}`, (error0, connection) => {
                    if (error0) {
                        rej(error0);
                    } else {
                        connection.on('close', () => {
                            this.channel = null;
                            this.responseQueue = null;
                        });
                        connection.createChannel((error1, channel) => {
                            if (error1) {
                                rej(error1);
                            } else {
                                channel.assertQueue(this.HANOI_QUEUE, {
                                    durable: false
                                });
                                this.channel = channel;
                                res(this.channel);
                            }
                        });
                    }
                    this.creatingChannel.next(false);
                });
            });
    }
Главная часть этого кода проста: в connect(...) устанавливается подключение connection к RabbitMQ, в connection.createChannel используется соединение для создания канала channel, с помощью которого подтверждается, что очередь hanoi существует.
Такое нагромождение необходимо для корректной работы этого метода, выполняемого в асинхронном контексте. Установленный канал channel сохраняется в локальном поле — так его не нужно создавать при каждой отправке сообщения.
Клиент
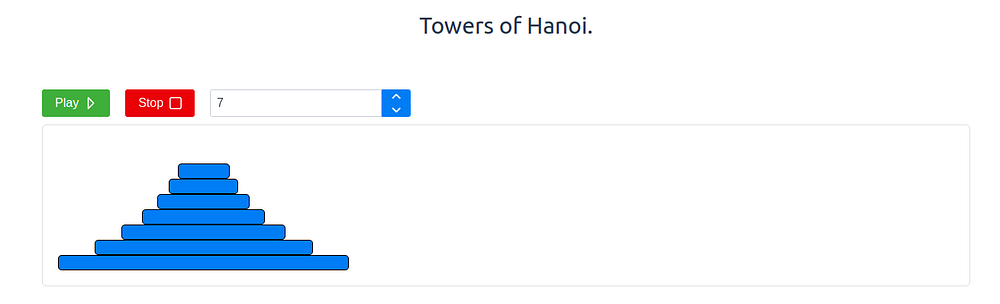
Кроме того, в main server размещается небольшое клиентское приложение с поддержкой Vue.js. Весь код для реализации есть в репозитории. Его цель — следующий простой пользовательский интерфейс:
Docker-compose
Сборка компонентов идет в контейнере docker-compose, где все они объединяются. Вот содержимое соответствующего docker-compose.yml:
version: "3"
services:
  main-server:
    build: ./main-server
    env_file: .env
    environment:
      - RABBITMQ_HOST=rabbitmq
    ports:
      - "3000:3000"

calc-engine:
    build: ./calc-engine
    env_file: .env
    environment:
      - RABBITMQ_HOST=rabbitmq

rabbitmq:
    image: rabbitmq:3-management
Если клонировать репозиторий и установить докер на компьютере, код можно запустить с терминала следующей командой (она в корневой папке репозитория):
> docker-compose up
После вводим в браузере http://localhost:3000, и пользовательский интерфейс перед нами.
Заключение
Это не единственный подход к разделению приложения на несколько единиц компиляции. В контексте Node.js еще есть перспективный NAPI-RS, позволяющий избежать накладных расходов на сообщения.
С другой стороны, помещая разные части приложения в отдельный сервер (микросервер), получаем преимущество дифференцированной масштабируемости — каждая часть может быть масштабирована или сделана с учетом особенностей ее запуска в кластере.
Источник: https://nuancesprog.ru/p/16265/