Репозиторий(Repository)
KarmanovichDevРепозиторий(хранилище) - Шаблон проектирования, который служит абстракцией над уровнем хранения данных. Обычно предоставляет интерфейс, схожий с коллекцией: CRUD операции над сущностью + кастомные методы для фильтрации получаемых данных.
Этот паттерн, один из самых часто используемых мною. В преобладающем большинстве проектов, в разработке которых я принимал участие, есть база данных а, значит, есть и репозитории. Но даже отсутствие базы данных в проекте не помешает нам применять этот паттерн, если нам нужно скрыть детали реализации того, как получаются данные. Другими источниками данных могут быть: сторонний сервис, дисковое пространство на вашем ПК, облачное хранилище, noSQL решение, например, redis и т. п.
Давайте поговорим о преимуществах репозитория:
- Служит абстракцией над уровнем данных, отделяя слой хранения данных от бизнес-логики. Не нужно везде писать похожие куски кода, которые обращаются в ORM или того хуже, в драйвер базы данных, тем самым смешивая эти слои.
- Централизовать доступ к данным. Один объект(класс) полностью берёт на себя ответственность за одну сущность. Также паттерн поддерживает принцип DRY(знание о том, как работать с конкретными данными, лежит в одном месте). Все, кому требуются эти данные, будут получить их через репозиторий.
- Ну и не стоит забывать про тестирование. Паттерн отлично помогает писать изолированные тесты на ваш код, позволяя подменять реализацию репозитория во время тестов, например, с помощью внедрения зависимостей.
Схема паттерна(UML):
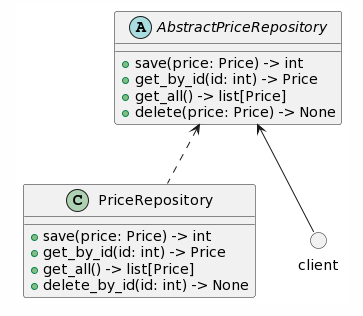
Клиентский код использует абстрактный репозиторий(AbstractPriceRepository) ничего не зная о конкретном(PriceRepository) и деталях его реализации. Это называется инверсия зависимостей(soliD), она даёт нам возможность отделить клиентский код от слоя инфраструктуры в данном случае.
Репозиторий, как говорилось выше, служит абстракцией над уровнем хранения данных. Но что это значит? И что плохого в том, что у меня нет репозитория?
Вот пример кода без репозитория:
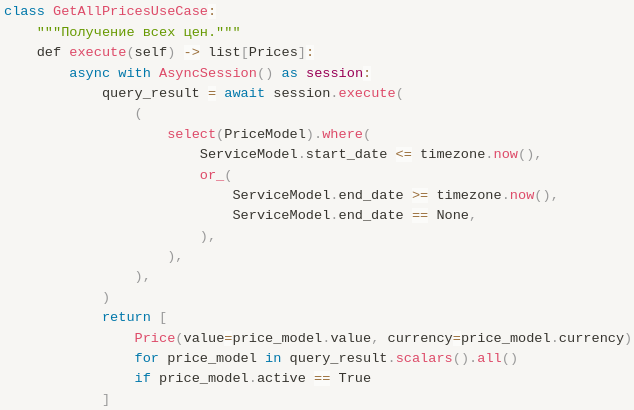
Здесь нет кода, который бы выполнял бизнес-логику, кроме возврата списка Price. Это всё инфраструктурный код получения данных. В чём же тут проблема ? Проблема в том, что у вас ещё нет никакой бизнес-логики, но она уже завязана на инфраструктуру, знает об уровне хранения данных и даже конкретном фреймворке. Так чем же это всё-таки нам вредит? Работает же!
- Любые изменения на уровне хранения данных влекут за собой изменение в коде бизнес-логики и наоборот(это один и тот же код). Тем самым появляется вторая причина для изменения кода, а это прямое нарушение SRP(Solid). Проблема двух причин изменения также в том, что каждый раз вам нужно тщательно обдумывать ваши изменения, чтобы не сломать код бизнес-логики, меняя код хранения данных, и наоборот.
- Да, это достаточно редкая ситуация, но всё же, как заменить ORM, если она вплетена в бизнес логику? Ответ - сложно! И если конкретно вы с таким не сталкивались, это не значит, что много старых проектов, в том числе моих, хотели бы, например, переехать на асинхронный ORM взамен синхронному. Это вполне реальная ситуация.
- Тестирование, тестирование и ещё раз тестирование. На такой код ничего, кроме интеграционных тестов написать не получится. Почему это плохо? Это медленно и тестирует как понятно из названия, интеграцию нескольких механизмов. Но что, если у каждого из механизмов по десять if(ов)? Сколько интеграционных тестов получится в итоге, чтобы покрыть все кейсы? А если механизма будет три, четыре? Ответ - Много! И тесты эти будут сложны, а это я ещё раз напомню, ВРЕМЯ. И если вам кажется, что 200 секунд ничем не хуже, чем 20, то значит, вы просто не пишите тесты по TDD и, скорее всего, не запускаете свои тесты достаточно часто, чтобы гарантировать работоспособность системы на любом этапе написания очередной фичи(об этом в другом раз).
Как бы выглядел код с репозиторием:
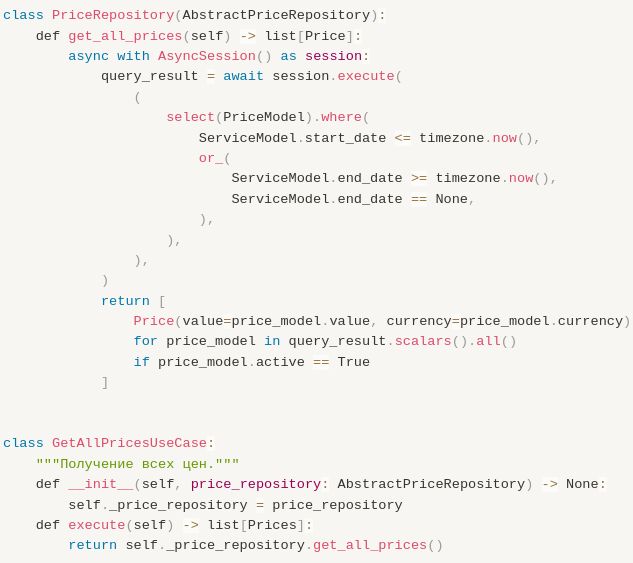
Вернёмся к трём предыдущим проблемам:
- Изменения уровня хранения данных теперь не заденут и не завяжутся на бизнес логике и наоборот. Как и писал выше, можете увидеть, что бизнес-логики в этом примере минимально возможное кол-во.
- Сервисный объект(GetAllPricesUseCase) зависит от абстрактного репозитория и ничего не знает о деталях реализации конкретного. Значит, при надобности в любой момент можно внедрить любую другую реализацию репозитория цен, а бизнес-код продолжит работать как ни в чём не бывало(Клиентский код всё так же использует только интерфейс).
- Теперь ничего не мешает протестировать наш сервисный объект изолировано модульными(юнит) тестами, и использовать объект заглушку(мок) или подставной объект(фейковый класс) вместо реального репозитория, который бы ходил в базу(расскажу во второй части статьи).
Ещё больше информации во второй части:
- Немного глубже расскажу о репозитории и как его нужно позиционировать(его ответственности, транзакционная целостность и т. д.)
- Как репозитории помогают тестировать остальной код.
- Как можно тестировать репозитории(модульные и интеграционные тесты).
- Ещё два примера реализации репозитория, когда у нас нет привычной для нас базы данных или ORM.