Разбор отбора всесиб
Algo_easyНеофициальный разбор от команды @algo_easy. @algo_easy в телеграмм - это удобство и разборы в тот же день. Всё в одном месте!
Для быстрого перемещения тыкните на ссылку:
Задача A
Задача B
Задача C
Задача D
Задача E
Задача F
Задача A
С помощью операций можно получить любое число. На самом деле, вас просят число представить в троичной записи. Ведь когда вы представили, легко понять какую из операций надо делать. Значит вам надо вывести длину вашего представления в троичной записи.
Если коротко, то наименьшее k, что n>3^(k-1) и n<=3^k. Обычно так находится длина троичной записи.
Задача B
Это типичная задача на два указателя или бинпоиск. Сначала проверьте, что вся сумма массива >S. Если <=S, значит ответ n. После проверки(то есть >S) мы получаем, что нужно просто найти отрезок массива в суммой <=S и наибольшей длиной. Так как числа по кругу, нам не хочется заморачиваться над тем, что надо иногда брать префикс и суффикс массива. Давайте просто запишем массив два раза друг за другом.
Тогда надо найти отрезок наибольшей длины <=S. Будем поддерживать два указателя L и R - текущие границы отрезка. Тогда, при сдвиге R на один вправо, надо L сдвигать тоже вправо, пока сумма на отрезке >S(с помощью while).
Метод указателей лучше погуглить, если не знаете)
Задача C
Результат не зависит от операций. Вот подумайте, что такое (a+1)*(b+1)-1, что такое ((a+1)*(b+1)-1)*(c+1)-1. Раскройте скобки. Теперь заметьте, что для n чисел a1...an, которые у вас 1...n по условию, вы получаете какое-то значение. Вам на самом деле не важно, какие там значения. Можно лишь сделать замечания, что это 1*2...*n+1*2*...*n только без одного множителя(таких n штук)+1*2*...*n только без двух множителей(таких n*(n-1)/2 штук)+.... +1*2*...*n только без n-1 множителей(то есть 1+2...+n)
В таких задачах обычно надо проверять для маленьких случаев. Например, мы поняли, что ((a+1)*(b+1)-1)*(c+1)-1=(a+1)*((b+1)*(c+1)-1)-1 -> то есть порядок операций не важен. Теперь просто объединяйте первое и второе число.
Уточнение: в интерактивках лучше писать cout << (запрос или ответ) << endl. Endl - всегда сбрасывает буфер обмена.
Задача D
Заметьте, что вы каждый запрос либо пропускаете(если одно из пуджей уже убили), либо убиваете пуджа. То есть запросов, которые вы не пропускаете не более n. Тогда надо проверить на отрезке между двумя пуджами, есть ли еще один пудж(если несколько то ближайший). Это можно делать за линию с помощью ориентированных площадей треугольников(загуглите векторное произведение, если не знаете). То есть асимптотика O(n^2).
Задача E
Сделаем предпосчет. Хотим для каждого числа все его делители найти, чтобы потом не находить за корень. Сделаем это за n/1+n/2+...n/n = O(n log n). Это делается тем, что мы для числа i проходим по всем числам, которые он делит. Еще заранее надо предпосчитать, сколько раз встречается полуинтервал между двумя соседними делителями(простая формулка).
Первое решение, это корневая по массиву N. Мы поддерживаем разностный массив. Тогда ответ на '?' это сумма на префиксе разностного массива, которую можно посчитать за корень. А на запрос '+' - мы смотрим пары соседних делителей. Пусть есть полуинтервал [L, R) на котором прибавляется эффективность, где L, R - соседние делители. Тогда прибавим add[L]+=w, add[R]-=w, где w = эффективность*(сколько раз возьмем этот полуинтервал).
Спасибо за второе решение, от @s_k_a_r_a. Будем использовать корневую декомпозицию по запросам. Что это?
Мы будем запросы делить на корень из q запросов(корень буду обозначать sqrt) по блокам. То есть в первом блоке запросы с номерами 1...sqrt(q), в втором sqrt(q)+1....2*sqrt(q)... Обычно пишут k=sqrt(максимальное значение q), в данной задаче примерно 500. И поддерживаем для каждого числа - какая эффективность у него.
Теперь внутри блока возьмем все запросы '?' и отсортируем их. Тогда на '+' можно отвечать за кол-во делителей+кол-во '?'. Надо одновременно проходить по соседним делителям и отсортированным '?'(похоже на два указателя).
Обновление идет каждые K запросов. Просто проходите по последним K запросам и для них с помощью разностного массива изменяете эффективность каждого числа. Вернее сначала считаете разностный массив, а потом пробегаетесь по каждому числу и изменяете массив(который отвечает за эффективность каждого числа).
Задача F
Спасибо @s_k_a_r_a за обсуждение задачи, набросок идей, проверку решения.
Построим бор(или сжатый бор). Тогда будем относится к задаче, как к подвешенному дереву. Терминальная вершина - вершина, в которой заканчивается хотя бы одно слово. Сделаем общие наблюдения(порисуйте):
1) Вам нужно заходить в терминальные вершины в порядке возрастания длины. Если зашли в более длинную строку и потом перешли в меньшую по длины через LCA, то давайте сделаем это обратным ходом, ответ не ухудшится.
2) Вы можете прийти в терминальную вершину u через другую вершину v через их LCA.
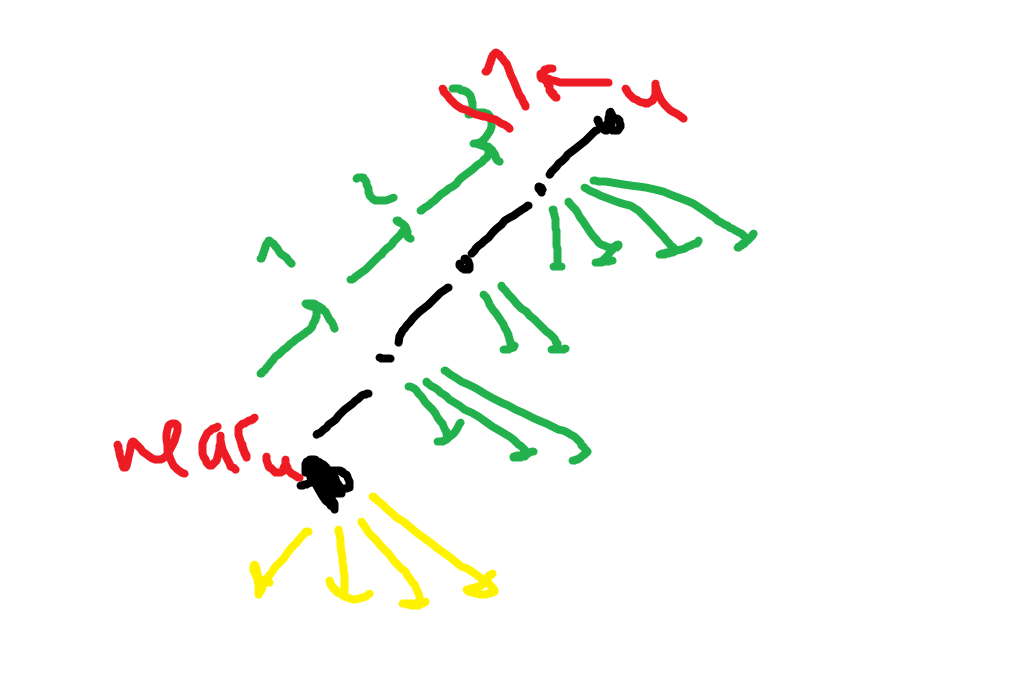
Зайдем в ближайшею к корню терминальную вершину. Тогда пусть это будет первая строка, которую мы получим(она минимальной длины, поэтому подходит). Теперь подвесим за нее все дерево. Тогда посчитаем для каждой вершины ближайшую к ней терминальную вершину в ее поддереве. Пусть будем массив near[u]. Тогда мы знаем, что корень - терминальная вершина, которую уже достигли.
Смотрите картинку. Мы будем рекурсивно делать следующее: Изначально root - корень. Посмотрим на всех детей u. Для ребенка u из-за факта 1 надо зайти в near[u], потому что все остальные длины >= той, которая near[u]. Для near[u] сделаем тоже самое, что и root, то есть на всех детей(рекурсию делаем). Дальше пойдем обратно к u и будем для каждой вершины на пути смотреть на детей и для них делать ту же самую рекурсию. Посчитать расстояние легко - надо взять минимумы из dist(v, u) и dist(v, near[u]). Зеленое на рисунке - это расстояния до вершин.