Поиск по фото
Romanov NikitaЭта и другие статьи про рекомендации в Wildberries выходят в рамках телеграм канала @wildrecsys
Введение
Привет, меня зовут Романов Никита - Тимлид команды визуально похожих товаров и поиска по фото в Wildberries. И сегодня я расскажу о том, как работает поиск по фото - сервис делает процесс покупок проще и быстрее, помогает пользователям находить именно то, что им нужно, без необходимости подбирать нужный текст или длинное описание.
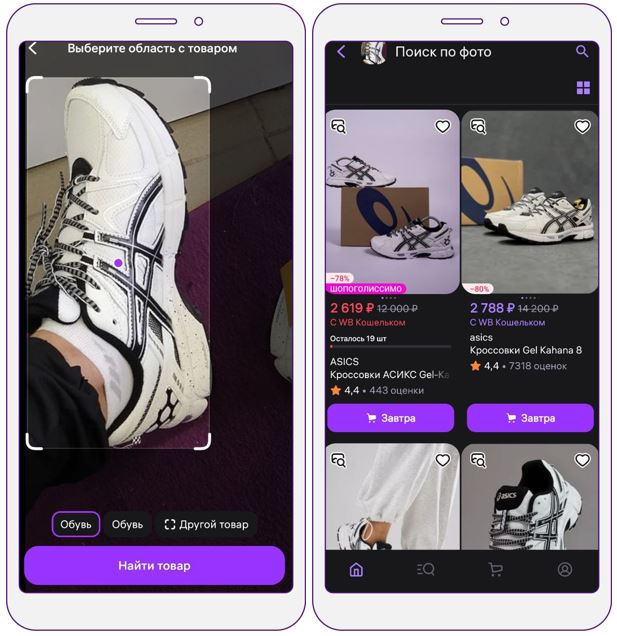
Архитектура поиска по фото
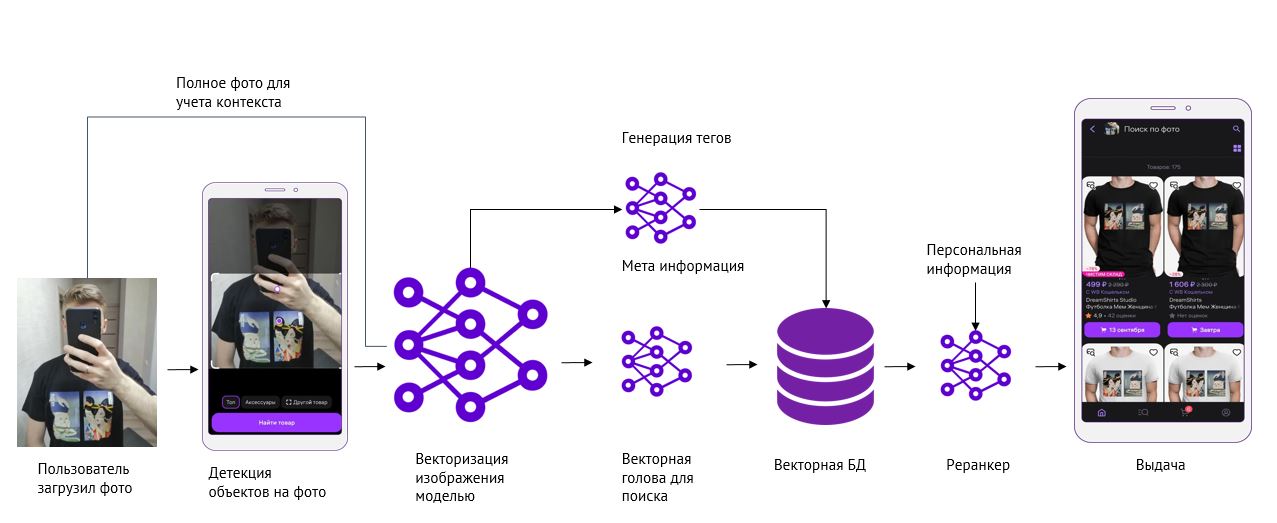
Рассмотрим основной пайплайн. На данный момент эта схема актуальна для мобильных платформ (iOS и Android).
- Загрузка фотографии. Базовое действие, которое совершает пользователь. Домен исходного изображения может быть разный - скриншот с мобильного телефона или соц. сети, пользовательское фото или товар с маркетплейса.
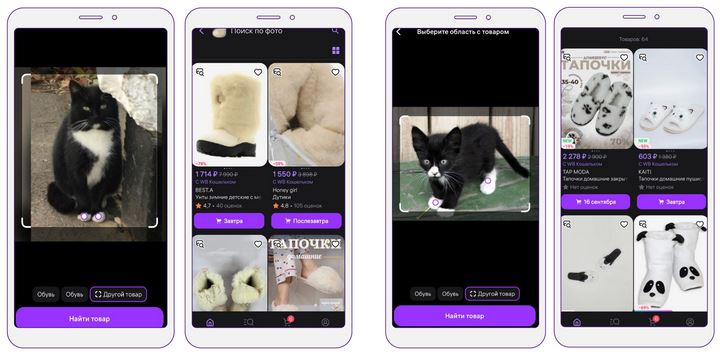
- Детекция объектов на фото. После того, как пользователь загрузил свою фотографию, она попадает в сервис детекции, который работает в домене одежды.
- Векторизация изображения моделью. После предыдущих этапов целое или обрезанное детекцией изображение обрабатывается эмбеддинговой моделью для получения вектора. Также после вектора из основного бекбона получаем мета информацию (категория товара, пол, возраст) для более точного поиска БД. Таким образом, для первого примера будем искать кроссовки в категории "Обувь", а не в всём большом пространстве товаров. Это ускоряет и уточняет поиск.
- Векторная БД. Используем qDrant для хранения всех актуальных векторизованных фотографий на маркетплейсе.
- Реранкер. Бустинговая модель для переранжирования результата с учётом всех характеристик товаров включая векторные представления.
- Выдача. В результате получаем релевантную подборку. Это кстати реальный пример, предлагаю попробовать 🙂.
Детектор
Цель детектора – выделение с фотографии главного объекта, который будет использован для поиска.
Какие проблемы решаем детекцией:
- На фото может быть несколько объектов
- Один и тот же человек в разной одежде
- Лишний текст (если это скриншот)
- Композиция и фон
Для обучения собрали и очистили открытые датасеты с одеждой (самая продаваемая на WB категория товара). DeepFashion (multimodal / in-shop), ModaNet, Fashionpedia - в датасетах есть разметка на нужные категории, сегментационная разметка и описание на английском, а также дополнительно заказывали разметку асессорам. Разметка полигонами сильно повышает качество финальной разметки и разбита на 13 основных категорий, которые может надеть на себя человек.
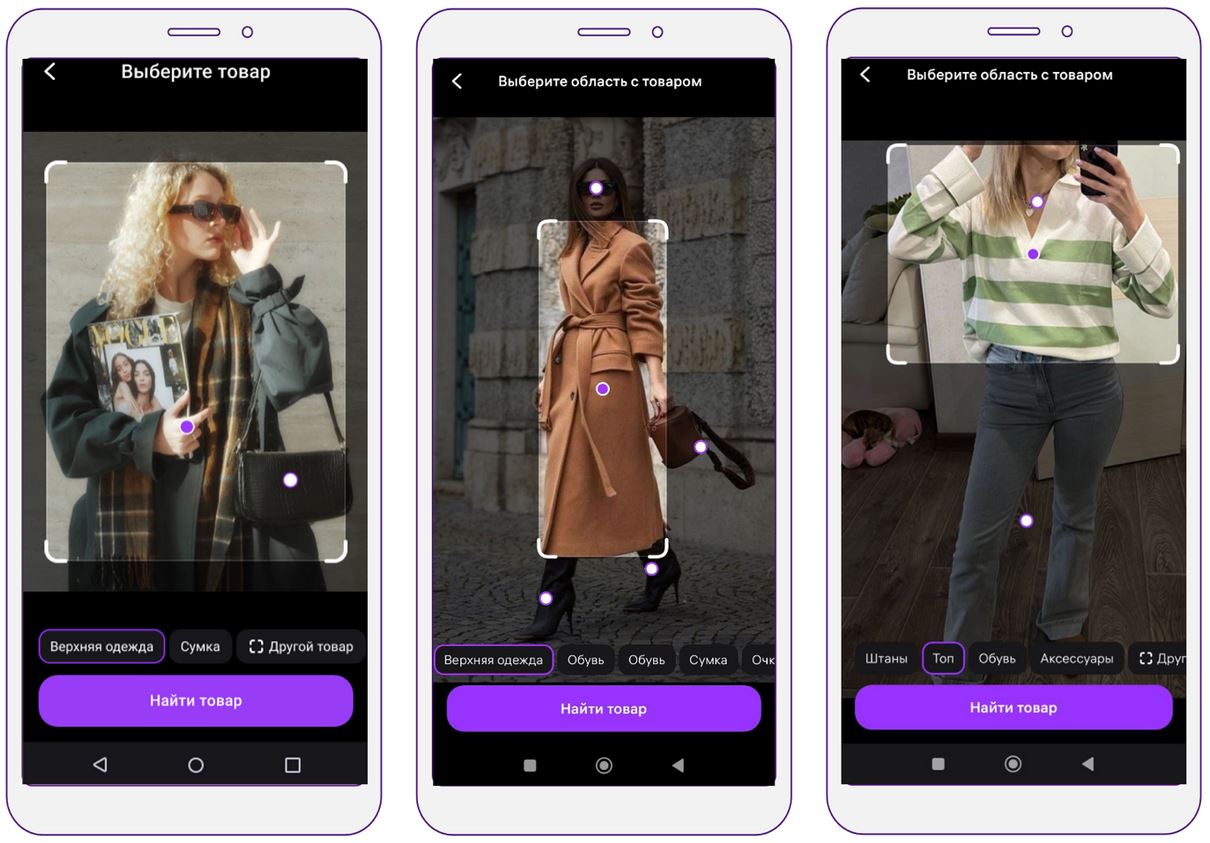
На данный момент используем модель с открытым словарём - YOLOWorld (заменила предыдущую YOLO8) и активно расширяем количество категорий - на все товары, которые встречаются на нашем маркетплейсе.
Полученный результат используем для более точного поиска, хорошо распознаём элементы одежды и понимаем что именно хочет найти пользователь. Есть и побочный эффект:
Эмбеддинговая модель
Цель эмбеддинговой модели – обработка входного изображения и преобразование в векторное представление для дальнейшего хранения, переиспользования и поиска.
Обучаем модель последовательно двумя подходами.
Первый подход — CLIP (мультимодальный подход для объединения текстовых и визуальных данных), обучается на больших наборах пар «изображение-текст». Обучаем на датасете данных WB – первое фото из карточки товара + текстовое описание товара с его характеристиками и открытом датасете LAION2B, который очщаем при помощи google/gemma-2-9b-it.
Какие бывают проблемы данных?
- Текст не информативен: допустим, изображено летнее женское платье, белое в красных горошек, и на нем просто написано «летнее платье» — на таких данных сильный результат не обучится и модель не научится различать текстуру и фасон.
- Текст слишком шумный: продавцы могут написать большое количество лишнего текста в наименовании и особенно в описании товара, который не будет хорошо описывать изображение
- На фото другие объекты или объект не основной на фото: это мешает обучению и модель не может выучить закономерности
Второй подход – модель обучается в режиме SSL (Semi-Supervised Learning)
Обучение запускаем по размеченным и не размеченным данным. В нашем случае используются размеченные позитивные примеры и семплируем негативные.
Для обучения используются открытые датасеты с различными доменами изображений в т.ч. DeepFashion – для валидации и визуализации, а также датасеты на основе данных WB – фото из карточки товара и отзывов. Делаем предварительную очистку данных предобученными векторными моделями и размечаем асессорами.
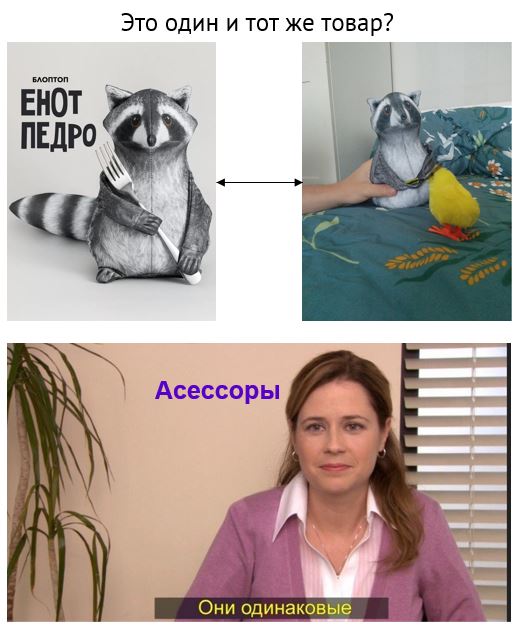
Выбор бейзлайна модели на основе основных метрик для сервиса:
- RPrecision@k - Точность распознавания - ищем тот же самый товар
- KNN_Precision - Точность семантики (в каком-то смысле проверка модели на адекватность поиска) - ищем товар того же класса
- KNN_F1_weighted - Взвешенная по точности / полноте семантика
На момент начала ресерча (начало 2024) собрали и протестировали на hold out датасете пул моделей с HF:
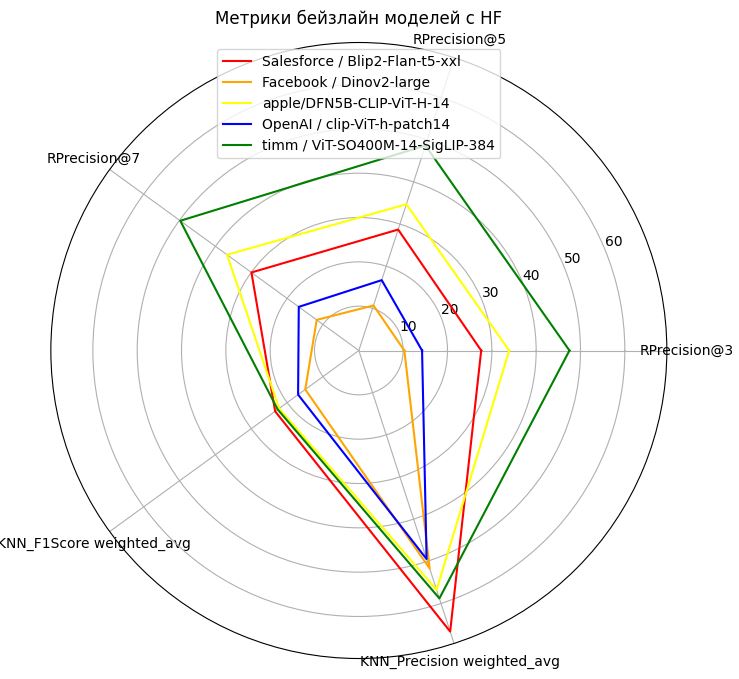
Приняли решение обучить несколько бейзлайнов и сравнить результат. На оффлайн метриках и визуальном анализе заметно, что модель BLIP2 хорошо умеет в семантику, в то же время заметили что модель DinoV2 - хорошо работает с текстурой объектов. Решили объединить эти 2 модели (DiB) чтобы проверить нашу гипотезу (вдохновились идеей из статьи OmniFusion). Провели ряд экспериментов и с другими моделями - вектора DinoV2 не сходились с векторами DFN5B и SigLIP, поэтому обучали только основные бекбоны.
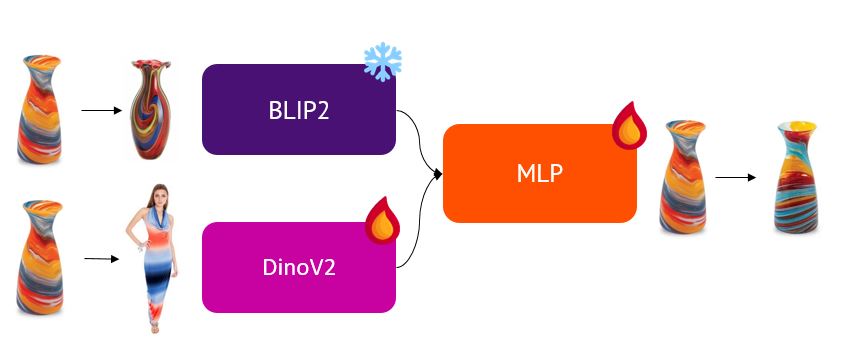
Количество данных в обучении CLIP порядка 500к пар «изображение-текст» и порядка 5млн изображений для SSL. Результат обучения на оффлайн метриках:
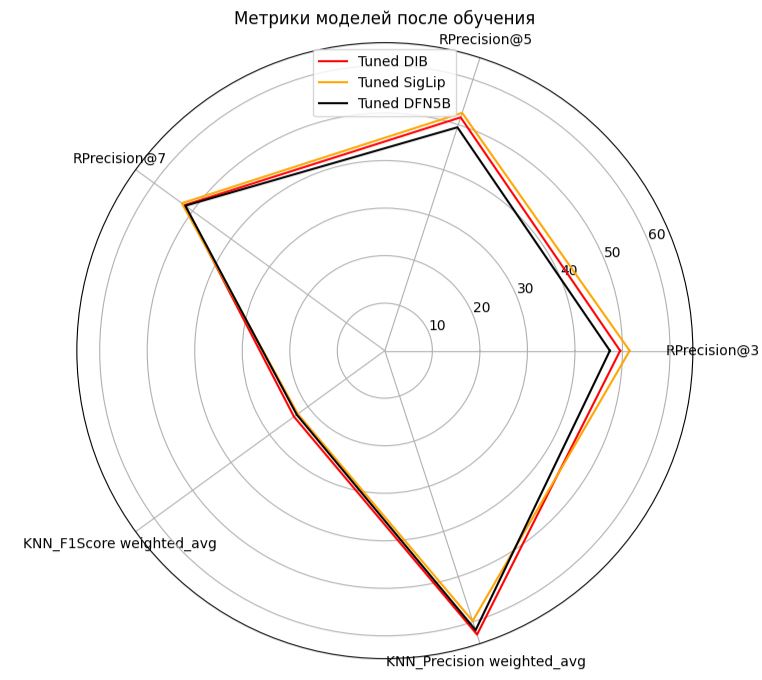
Приняли решение использовать чекпоинт DiB - лучшее качество по семантике и разумный trade-off с метриками распознавания.
На момент написания статьи в наш пул претрейн моделей для замера метрик визуальных энкодеров добавили Pixtral-12B, Phi-3.5-vision-instruct, Llama-3.1-8B-Instruct, Qwen2-VL-2B-Instruct, colpali-v1.2.
Продолжение следует...
Мы проверили несколько гипотез и обучили модель с сильной метрикой распознавания и адекватной семантикой, далее необходимо организовать быстрый векторный онлайн поиск с возможностью масштабирования и отранжировать финальный результат, для этого мы используем qDrant и Catboost, более подробно расскажу об этом в следующем посте