Почему rows[0] может вызвать IndexError при пустом CSV
@python_quizРазберем этот квиз
Код из квиза:
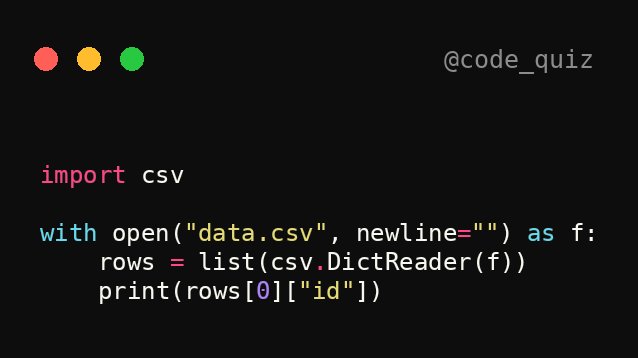
Коротко: менеджер контекста корректно закрывает файл, но это не защищает от доступа к несуществующему элементу списка. Если файл существует, но в нём нет строк данных, попытка обратиться к rows[0] приведёт к IndexError. Ниже — подробный разбор и безопасные альтернативы.
Что делает код по шагам
- open('data.csv', newline='') открывает файл (контекстный менеджер гарантирует закрытие по выходу из with).
- csv.DictReader(f) создаёт объект-итератор, который при первой итерации читает заголовок (fieldnames) и затем выдаёт строки как словари.
- list(...) полностью потребляет итератор и собирает все строки в список rows.
- print(rows[0]['id']) пытается получить первую строку и извлечь значение по ключу 'id'.
Важные случаи (наличие/отсутствие файла и содержимого)
- Если файла нет — при open() будет вызвана ошибка
FileNotFoundError. - Если файл существует, но пуст (0 байт) — DictReader не выдаст ни одной строки, list(...) даст пустой список rows == [], и rows[0] вызовет
IndexError. - Если файл содержит только заголовок (например, "id,name\n") но без строк данных — тоже rows == [].
- Если файл содержит строки, но в заголовке нет колонки 'id' — обращение через rows[0]['id'] даст
KeyError.
Эти сценарии важно учитывать при обработке CSV.
Разбор вариантов ответов (анализ утверждений)
1) "Код безопасен: менеджер контекста предотвращает утечку и ошибок не будет"
Анализ: менеджер контекста действительно предотвращает утечку файловых дескрипторов (файл будет закрыт). Но это не гарантирует отсутствие ошибок при доступе к элементам списка или ключам словаря. Следовательно утверждение вводит в заблуждение — часть про предотвращение утечек верна, часть про отсутствие ошибок — нет.
2) "Если data.csv существует и пустой, rows=[] и rows[0] вызовет IndexError"
Анализ: это корректное описание поведения. При пустом файле список строк действительно будет пуст, и обращение к rows[0] поднимет IndexError.
3) "DictReader сам закроет файл и вернёт пустой словарь при пустом CSV"
Анализ: DictReader сам по себе не закрывает файл — за это отвечает with/close вызываемый пользователем. Также при пустом CSV DictReader не возвращает "пустой словарь"; он просто не выдаёт ни одной строки, поэтому list(...) даёт пустой список. Утверждение неверно.
4) "os.path.exists гарантирует, что CSV не будет пустым"
Анализ: существование файла по пути не гарантирует, что он не пустой — файл может существовать и иметь размер 0 байт или содержать только заголовок. Утверждение неверно.
Безопасные варианты чтения первой строки
Рассмотрим несколько практических способов безопасно получить первую строку или значение поля 'id'.
1) Использовать next() с дефолтным значением — не придётся материализовывать весь список:

2) Перевести в список и проверить наличие элементов:
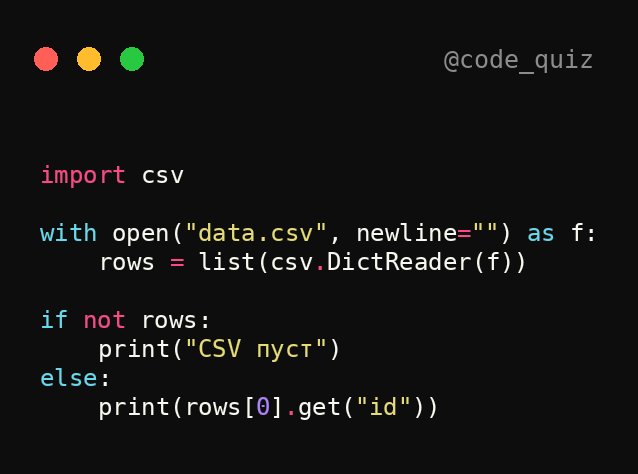
3) Ловить исключение IndexError (менее предпочтительно для контроля потока):
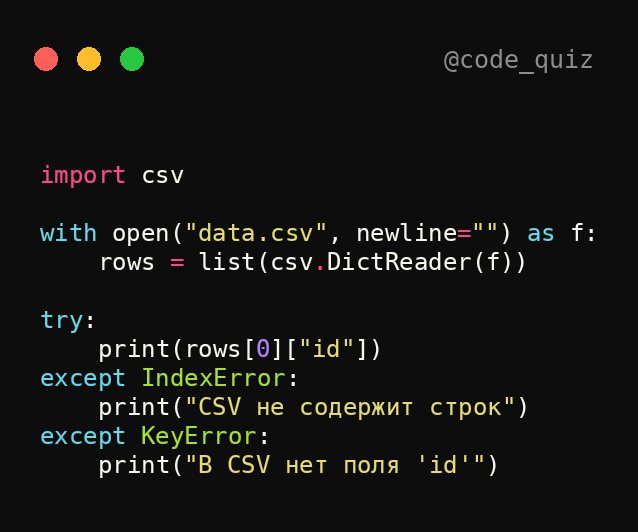
4) Проверять размер файла перед чтением (опционально):
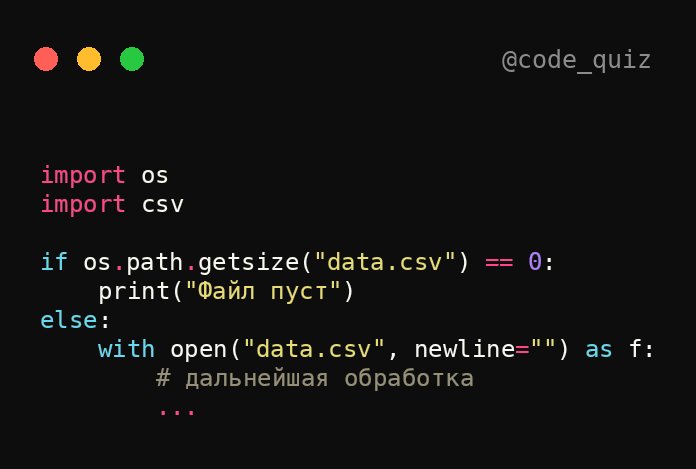
Учтите, что проверка размера файла помогает избежать открытия пустого файла, но не различает наличие только заголовка или отсутствие нужной колонки.
Дополнительные замечания и рекомендации
- Всегда проверяйте, что файл существует и содержит ожидаемые данные, если код критичен.
- Используйте first.get('id') вместо first['id'] если поле необязательно — .get вернёт None вместо
KeyError. - Предпочтительнее обрабатывать первые элементы через next(reader, None), когда нужно только первое значение — это экономит память и быстрее для больших файлов.
- Менеджер контекста гарантирует закрытие файла, но не защищает от логических ошибок (пустой список, отсутствие ключа и т. п.).
Вывод
Контекстный менеджер закрывает файл корректно, но не устраняет ошибку доступа к несуществующему элементу списка. Для безопасной работы с CSV нужно явно обрабатывать случаи пустых файлов/отсутствия строк и возможное отсутствие нужной колонки. Использование next(reader, None) и .get() делает код более устойчивым и понятным.