Ограничить RAM сервиса в Linux через systemd и cgroup v2
Кто уже какое-то время держит Linux-серверы, тот переживал какой-то вариант этого инцидента: один сервис (дырявое приложение, batch-джоба, запрос, ушедший вразнос) растет, пока весь хост не уходит в thrashing, и к тому моменту, когда просыпается OOM killer, он убивает то, что вам было дороже настоящего виновника. Работа с zram и zswap из предыдущей статьи защищает вас от пиков, но против этого не делает ничего.
Сейчас это важнее, чем раньше. При ценах на RAM 2026 года естественная реакция: уплотнять больше нагрузки на те хосты, которые у вас уже есть. И уплотнение здраво, только если отказ одного сервиса не может утянуть за собой остальные. Именно это дают вам cgroup v2 и systemd.
Начните с того, что сервис реально потребляет
Прежде чем ставить любой лимит, проверьте, что вы на cgroup v2, и посмотрите реальное потребление сервиса:
stat -fc %T /sys/fs/cgroup
systemctl show app.service -p ControlGroup -p MemoryCurrent -p MemoryPeak -p MemorySwapCurrent
Первая команда должна напечатать cgroup2fs. Подставьте свой сервис вместо app.service и понаблюдайте за пиком под репрезентативной нагрузкой. Именно из этой цифры берется ваш бюджет: измеренный working set, а не «25% хоста» и не какая угодно произвольная доля, которая кажется справедливой.
Четыре настройки, которые важны
systemd выставляет контролы памяти cgroup v2 как свойства юнита:
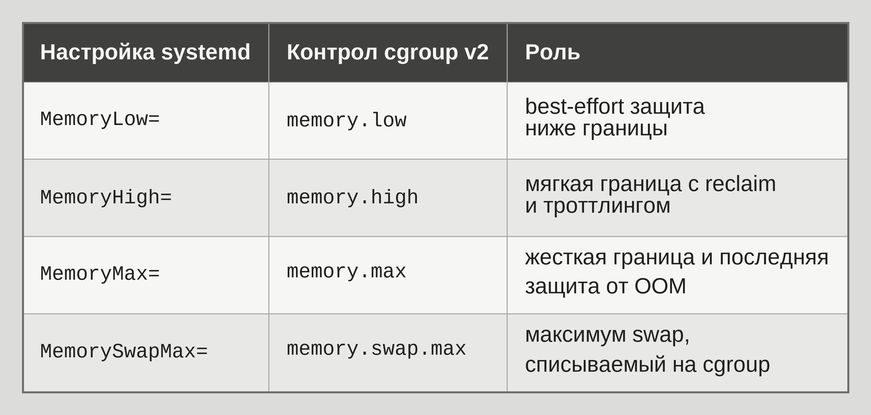
Замысел стоит понять, потому что большинство сразу хватается за MemoryMax и на этом останавливается. MemoryHigh задуман как ваш главный рабочий регулятор: при пересечении внутри cgroup запускаются reclaim и троттлинг, сервис замедляется, и в вашем мониторинге всплывает давление, которое вы видите и на которое можете среагировать. MemoryMax - стена за ним. Если вы поставите только стену, сервис на полной скорости влетает в жесткий OOM, и перед этим нет видимой зоны предупреждения.
Сначала попробуйте обратимо
Скажем, у сервиса стабильный working set 1,2 GiB и легитимные пики ниже 1,6 GiB. Разумный первый бюджет:
sudo systemctl set-property --runtime app.service \
  MemoryHigh=1500M MemoryMax=1800M MemorySwapMax=512M
Флаг --runtime значит, что все исчезнет при перезагрузке, а для теста вам именно это и нужно. Теперь дайте нагрузку и смотрите, что происходит:
watch -n 1 'systemctl show app.service -p MemoryCurrent -p MemoryPeak -p MemorySwapCurrent'
CG=$(systemctl show -p ControlGroup --value app.service)
sudo cat "/sys/fs/cgroup${CG}/memory.events"
sudo cat "/sys/fs/cgroup${CG}/memory.pressure"
В memory.events растущий счетчик high значит, что сервис пересек мягкую границу: изредка это ожидаемо, а если постоянно, это уже проблема. oom и oom_kill значат, что неправ либо бюджет, либо приложение. Один нюанс, который стоит усвоить: высокий PSI внутри cgroup при низком PSI на хосте доказывает, что изоляция работает. О том, приемлема ли еще задержка сервиса, это ничего не говорит. Проверяйте отдельно.
Чтобы отменить только тестовые лимиты, не трогая уже существующие override:
sudo systemctl set-property --runtime app.service \
  MemoryHigh=infinity MemoryMax=infinity MemorySwapMax=infinity
Сделайте постоянным
Когда бюджет переживает реальную нагрузку, положите его в override и никогда не правьте unit-файл из пакета напрямую:
sudo systemctl edit app.service

[Service]
MemoryHigh=1500M
MemoryMax=1800M
MemorySwapMax=512M
Потом:
sudo systemctl daemon-reload
sudo systemctl restart app.service
Рестарт - это настоящий перерыв в работе сервиса. Планируйте его как перерыв и после этого проверьте приложение.
Защитите то, что должно остаться живым
Лимиты давят вниз. MemoryLow толкает в другую сторону. Для маленького, но необходимого сервиса (прокси, агента мониторинга, того, что вам нужно работающим особенно, когда хост под давлением) эта настройка просит ядро пощадить этот бюджет при reclaim, на условиях best-effort:
[Service]
MemoryLow=256M
Две оговорки. Это работает, только если применено согласованно по всей иерархии cgroup, а защиты, которые вы раздаете, не могут в сумме превысить ту RAM, которая есть. Отсюда очевидная дисциплина: не защищайте всё. Если у каждого сервиса приоритет, его нет ни у кого.
Предсказуемый OOM лучше замерзшего хоста
Даже когда бюджеты на месте, хосты все равно могут оказаться в беде, а OOM killer ядра обычно приходит поздно и выбирает плохо. systemd-oomd использует PSI и cgroup v2, чтобы сработать раньше, пока хост еще отвечает:
systemctl status systemd-oomd
oomctl
Директивы ManagedOOMMemoryPressure= и ManagedOOMSwap= зависят от вашей версии systemd и иерархии юнитов, так что проверьте, прежде чем их включать:
systemd --version
man systemd.resource-control
man systemd-oomd.service
И держите перспективу: контролируемый OOM все равно простой. Убедитесь, что у юнита здравая политика рестарта, что данные остаются консистентными после kill и что ваш алертинг отличает намеренный kill от краша.
Контейнеры: проверьте, что лимит действительно есть
Рантаймы контейнеров переводят свои лимиты памяти в те же самые cgroup, а значит, YAML может говорить одно, а ядро другое. Проверяйте на уровне ядра:
systemd-cgls
systemd-cgtop --depth=3
Контейнер без лимита вообще не изолирован от RAM хоста. Лимит ниже обычного working set значит постоянный reclaim и рестарты. Огромный лимит существует только на бумаге. Метод тот же, без изменений: снимите baseline working set, поставьте мягкую границу с запасом, держите жесткую защиту за ней и смотрите memory.events.
Не выделяйте память, которой нет
Последняя ловушка: на хосте с 16 GiB не раздавайте сервисам 16 GiB MemoryMax так, будто не существует ни ядра, ни page cache, ни одновременных пиков. Оставьте явное место на ядро и его slab-кэши, на кэш файловой системы, который делает полезную работу, на сервисы доступа, логирования и мониторинга, на реалистичные накладывающиеся пики, на zram или zswap, если вы включили их в части 2, и на запас, с которым вы все еще зайдете по SSH и почините, когда что-то пойдет не так.
Частые вопросы
Чем отличаются MemoryHigh и MemoryMax?
MemoryHigh - мягкая граница, которая запускает reclaim и троттлинг. MemoryMax - финальная жесткая граница; если потребление удержать не удается, OOM killer срабатывает внутри cgroup.
Как мне временно ограничить RAM сервиса systemd?
Используйте systemctl set-property --runtime name.service MemoryHigh=... MemoryMax=.... Опция --runtime теряет изменения при перезагрузке и подходит для контролируемого теста.
Стоит ли отключать swap у сервиса?
Обычно нет. MemorySwapMax=0 может усилить давление и приблизить OOM. Ставьте потолок, только когда этого требует профиль задержек и вы уже замерили PSI и memory.events.