Обзор книги Designing Data-Intensive Applications by Martin Kleppmann
Nikita UlshinСегодня - обзор на настоящую библию разработчиков высоконагруженных систем. Designing Data-Intensive Applications, она же DDIA, она же “Высоконагруженные приложения”, она же “книжка с кабанчиком”. Не столь давно я прочитал её во второй раз и решил написать обзор, потому что считаю эту книгу крайне важной.
TL;DR
- Обзорное введение в проектирование высоконагруженных систем, всего лишь 650 страниц 🤣
- Познакомитесь со всеми видами сбоев и потенциальных проблем.
- Узнаете, как масштабировать своё приложение и какие проблемы возникают на новых уровнях.
- Не самое простое чтиво, рекомендую ребята от миддла и выше.
- Считаю строго обязательной для чтения.
Книга Клеппманна довольно большая, но стоит потраченного времени. Её можно фактически держать под рукой как пособие по решению тех или иных проблем высоконагруженных распределённых систем. При этом важно понимать, что Клеппманн не закапывается в супер-низкоуровневые детали той или иной темы. Он даёт ровно столько информации, сколько нужно для общего понимания. При желании вы прекрасно поймёте, куда копать дальше.
При этом книга совершенно не показалась мне избыточной, несмотря на довольно солидный объём. Клеппманн нашёл удивительный баланс между академической сухостью и водой-водицей уровня студенческого диплома. Читать приятно и интересно. Мозги у меня местами кипели, но не слишком - при должной въедливости во всех темах прекрасно можно разобраться.
Книга разделена на 3 большие части:
- Основы информационных систем.
- Распределённые данные.
- Производные данные.
Раздел 1 “Основы информационных систем”
Первый раздел “Основы информационных систем” знакомит нас с основными идеями, которые относятся к любой информационной системе вне зависимости от её размера. Здесь раскрываются три кита информационных систем - Надежность, Масштабируемость, Удобство сопровождения.
Также в этой главе я посмотрел на разные типы БД и принципы построения запросов к ним (про графовую было особенно интересно). Очень интересной оказалась третья глава, в которой довольно подробно рассказано про устройство индексов и разницу между OLAP/OLTP хранилищами. Завершается раздел важной главной про кодирование - преобразование структур данных в биты на диске или по сети. Здесь Клеппманн очень подробно даёт обзор разных форматов (XML, JSON, Protocol Buffers etc) и раскрывает проблемы прямой/обратной совместимости.
Раздел 2 “Распределённые данные”
Второй раздел “Распределённые данные” переводит нас в увлекательный мир, где БД работает на нескольких машинах. На мой взгляд, это самый важный раздел книги и поэтому ему я посвящу больше всего внимания.
Первой раскрывается такая тема, как репликация (хранение копий данных на нескольких машинах, соединённых по сети) и проблемы, возникающие при реплицировании данных (например, отказ master-ноды способен создать целый букет проблем). Также круто раскрыт вопрос решения проблем при задержке репликации. Затем описаны multi-master репликация (при которой неизбежно возникают конфликты записи) и репликация без мастера (в которой появляются проблемы согласованности и приходится применять хитрые решения типа выбора по кворуму). Последней идёт тема секционирования (разбиение большого куска данных на меньшие кусочки) и шардирование (вынесение этих кусочков на отдельные машины).
Отдельная большая глава посвящена транзакциям. Для начала автор высмеивает аббревиатуру ACID (которая так и не смогла устояться и в которую для красоты добавили букву С). А вот дальше начинается интересная и очень важная тема - уровни изоляции транзакций. Пожалуй, это лучший гайд по ним - подробный, со схемами и описаниями.
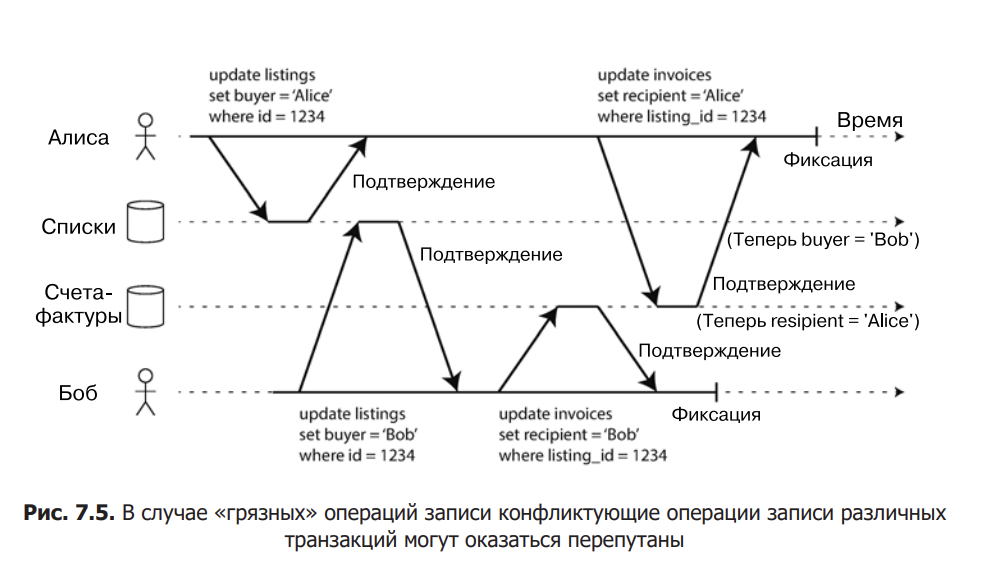
Вишенкой на торте стало описание алгоритма двухфазной блокировки (two-phase lock, 2PL). Конфликтов в БД у вас больше не будет, но цена за это - чудовищно низкая производительность.
Следующая тема - проблемы распределённых систем. Здесь рассматривается весь спектр проблем, которые могут возникнуть в системе из нескольких машин:
- Сбои и частичные отказы (как программные, так и аппаратные).
- Ненадёжные сети (и вообще сетевые проблемы в системах).
- Ненадёжные часы (показания часов на разных машинах могут значительно отличаться и это ведёт к проблемам с определением последовательностей событий).
- Византийские сбои (умышленное создание проблем в системе).
Последняя глава в этом разделе посвящена согласованности и консенсусу. Тема важная, потому что при отсутствии консенсуса в случае сбоя у вас в системе может образоваться два ведущих узла. Последствия будут крайне неприятными. В этой главе раскрываются различные уровни согласованности (и попутно высмеивается всем любимая теорема САР):
- Линеаризуемость - самая сильная гарантия. Система выглядит так, будто в ней всего одна копия данных и все операции атомарны. Сложно, больно, дорого 🙂
- Причинно-следственная упорядоченность - сохраняем последовательность событий, которые непосредственно связаны друг с другом.
Причинно-следственная упорядоченность создаёт вероятность конфликтов, поэтому заключительная часть главы посвящена консенсусу, который призван решить эту проблему.
Раздел 3 “Производные данные”
Третий раздел посвящен интеграции информационных систем между собой. Здесь рассматриваются пакетная обработка больших данных, модель пайплайнов Unix и модель обработки MapReduce. Здесь же мы знакомимся с такими инструментами, как Hadoop Distributed File System (HDFS) и Spark. После погружения в обработку больших данных автор знакомит нас с потоковой обработкой - когда данные поступают в систему постоянно и никогда не останавливаются. Здесь же затрагиваются техники перехвата данных (change data capture, CDC) и проблемы обогащения данных. Финалится книга интересными и довольно философскими рассуждениями Клеппманна на тему будущего информационных систем.
Итоги
- Книга - крутая и классная. Must read.
- Читать нужно внимательно и вдумчиво, но не всё. Например, последний раздел я читал далеко не так внимательно, как второй.
- Даже не пытайтесь всё запомнить. Прочтите, ознакомьтесь и держите под рукой как справочник.
- Если хотите расти дальше из программистов в проектировщики - считайте эту книгу первым шагом к своей цели.
- Из минусов - иногда книга кажется довольно поверхностной + некоторые упомянутые технологии уже успели устареть и уйти с рынка (тот же Riak, например).
- Толстая и кажется, будто никогда её не дочитаешь 🤣
🔥 10/10. Интересная и очень полезная книга, обязательна к чтению. Я прочитал второй раз и возможно буду читать ещё.
Немного моих заметок из книги
- Три кита информационных систем - Надежность, Масштабируемость, Удобство сопровождения.
- Поводы для распределения БД по нескольким машинам - масштабируемость, отказоустойчивость/высокая доступность, задержка.
- Репликация бывает асинхронной и синхронной. Асинхронная более надёжна, но можно потерять данные при сбое. Синхронная более хрупкая, но данные точно не теряются.
- Способы решения задержки репликации - read your own writes (пользователь всегда должен видеть свои изменения), monothonic reads (при нескольких операциях чтения подряд пользователь не увидит “продвижения назад во времени”) и consistent prefix reads (если операции записи выполняются в определённой последовательности, они будут в ней же и прочитаны). Все эти гарантии слабее strong consistency, но при масштабировании по-другому никак.
- Шардировать нужно вдумчиво. Неправильно выбранный ключ шардирования может создать “горячие точки” (перегруженные машины) или необходимость поиска по нескольким шардам. Для решения последней проблемы можно делать вторичные индексы по документами (локальные индексы) или по термам (собираем глобальный вторичный индекс из локальных по шардам).
- Основной принцип изоляции снимков состояния звучит как «чтение никогда не блокирует запись, а запись — чтение». Это обеспечивается за счёт MVCC (одновременное хранение множества версий одного объекта).