Хэш-таблица
Python SimpleХэш-таблица - структура данных имеющая ключ и привязанное к нему значение, пример в python - это dict. Используются, когда нам надо быстро получать данные по ключу.
Устройство хэш-таблицы:
Создается массив с ячейками, они называются бакетами (bucket). У этого массива есть вместимость (capacity). Когда мы кладем данные в эту хэш-таблицу, то данные пропускаются через хэш функцию, которая возвращает индекс ячейки нашего массива с бакетами. И наши данные помещаются в этот бакет.
Важно, что в бакете хранится и ключ и значение.
Рассмотрим пример:
Создаем хэш таблицу, допустим она будет на 8 элементов:
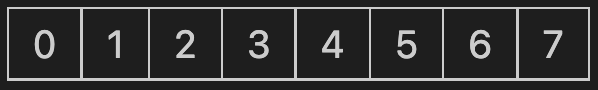
Хэш функция будет принимать ключ и делать из него значение от 0 до 7, чтобы можно было внести данные в массив.
Свойства хэш функции:
Быстрота и эффективность. То есть хеш функция не должна долго выполняться и быть тяжелой.
Необратимость. То есть если наша функция из ключа "key" получает значение 6, она не должна из ключа 6 получить значение "key"
Распределенность. То есть она должна разные ключи распределять по массиву, а не возвращать одно и то же значение.
Детерминированность. Это значит, что если ф-ия на ключ 123 сегодня вернула 5, то завтра она также должна вернуть 5 на этот ключ.
Для простоты, наши ключи будут целыми числами, а хэш функция, будет просто получать остаток от деления на 8, то есть Х % 8.
Теперь кладем в наш массив значение (буду писать не псевдокод, а как будто мы работаем со словарем в python)
d[33] = 100 # тут получаем 33 % 8 = 1, в ячейку 1 кладем (33, 100)
d[7] = 200 # тут получаем 7 % 8 = 7, в ячейку 7 кладем (7, 200)
d[20] = 300 # тут получаем 20 % 8 = 4, в ячейку 4 кладем (20, 300)
Получаем:
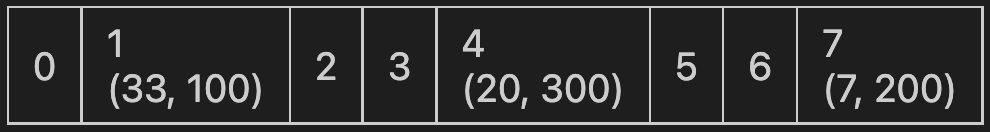
В 1, 4 и 7 ячейках мы добавили значения с ключом.
Справедливо возникает вопрос. Значений много, а ячеек мало, что будет, если хэш-функция вернет то же значение.
d[12] = 800 # тут получаем 12 % 8 = 4, в ячейку 4 кладем (12, 800)
При этом в бакет под номером 4 записываем ещё одно значение. Это называется коллизией.
Получаем:
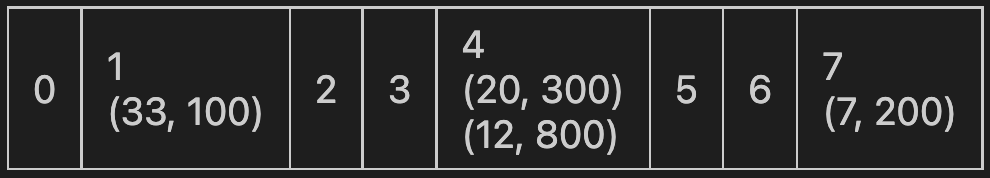
Один из способов связывать значения в бакете - это связанный список, то есть, есть бакет 4, он имеет ссылку на первый элемент в бакете (20, 300), этот элемент имеет ссылку на следующий (12, 800).
4 ->(20, 300)->(12, 800)
Теперь приходим к тому, зачем хранить ключ вместе со значением.
Нам надо получить значение по ключу 12, d.get(12) что при этом происходит?
Пропускаем 12 через хэш-функцию, получаем 4, идем в 4-ый бакет, и начинаем по ссылкам перебирать все элементы в бакете. Берем первый (20, 300), сравниваем ключ 12 != 20, идем дальше. (12, 800), 12 == 12. Ура! Возвращаем 800.
Удаление элемента происходит точно также, мы находим элемент и выпиливаем его, удаляя на него ссылки.
А что делать, если мы добавим много элементов, в маленькую таблицу, тогда сложность поиска будет далеко не О(1), т.к. в каждом бакете у нас будет записано по много элементов?
Есть такое понятие, как load factor, это коэффициент, который высчитывается как кол-во добавленных элементов разделить на capacity. В нашем примере это 4 / 8 = 0.5. Есть разные алгоритмы, но в среднем, когда этот коэффициент доходит до 0.7, то хэш-таблица автоматически увеличивается, например в 2 раза и все элементы переносятся в эту новую таблицу, при этом хэш функция пересчитывает все ключи и перераспределяет, ведь если мы получили хэш таблицу на 16 ячеек, то хэш функция будет не Х % 8, а Х % 16.