Google не индексирует JavaScript-сайт: почему дело не в «двух волнах рендеринга»
Александра ИоноваЕсли страницы на React или Vue не попадают в выдачу, очередь рендеринга почти наверняка ни при чём. Google рендерит всё, что отдаёт код 200, и обычно делает это за секунды. Ломается в другом месте: в исходном HTML, в кодах ответа сервера и в ресурсах, которые вы сами закрыли от бота.
«Две волны индексации» — модель 2018 года, которую сам Google свернул. В официальной документации описаны три фазы: сканирование, рендеринг, индексирование. Страница ждёт в очереди рендеринга обычно секунды, иногда дольше.
Второй волны сканирования не существует.
— Мартин Сплитт, Google, разбор JavaScript SEO
4 марта 2026 года Google вычистил из руководства по JavaScript-SEO раздел о доступности без скриптов. В журнале изменений объяснили: совет устарел, поиск рендерит JavaScript много лет, и загрузка контента скриптами больше не мешает Google.
Цифры вместо страшилок. Vercel и MERJ измерили задержку между сканированием и завершённым рендерингом на 37 000 сопоставленных пар (апрель 2024): медиана — 10 секунд, 75-й перцентиль — 26 секунд, 90-й — около 3 часов, 99-й — около 18 часов. Ни одной «второй волны через неделю».
Если Google не индексирует JavaScript-сайт, ищите здесь
- noindex в исходном HTML. Страница не уйдёт в рендеринг вообще, а скрипт, который снимает тег после загрузки, не выполнится: бот до него не дойдёт.
- Код ответа не 200. Ответы 3xx, 4xx и 5xx не рендерятся. Классика SPA: маршрута нет, а сервер отдаёт 200 с пустой оболочкой — Google получает soft 404.
- Ресурсы под robots.txt. Закрытые JS, CSS и внутренние API дают пустой рендер. Смотрите не только
/static/, но и эндпоинты, из которых фронт тянет контент. - Контент по действию пользователя. Краулер не кликает по табам, не жмёт «показать ещё» и не закрывает баннер куки. Всё, что появляется после клика, для индекса не существует.
- Ставка на состояние браузера. Рендер идёт без сохранения куки и localStorage между загрузками. Персонализация, которая подставляет контент из хранилища, отдаст боту заглушку.
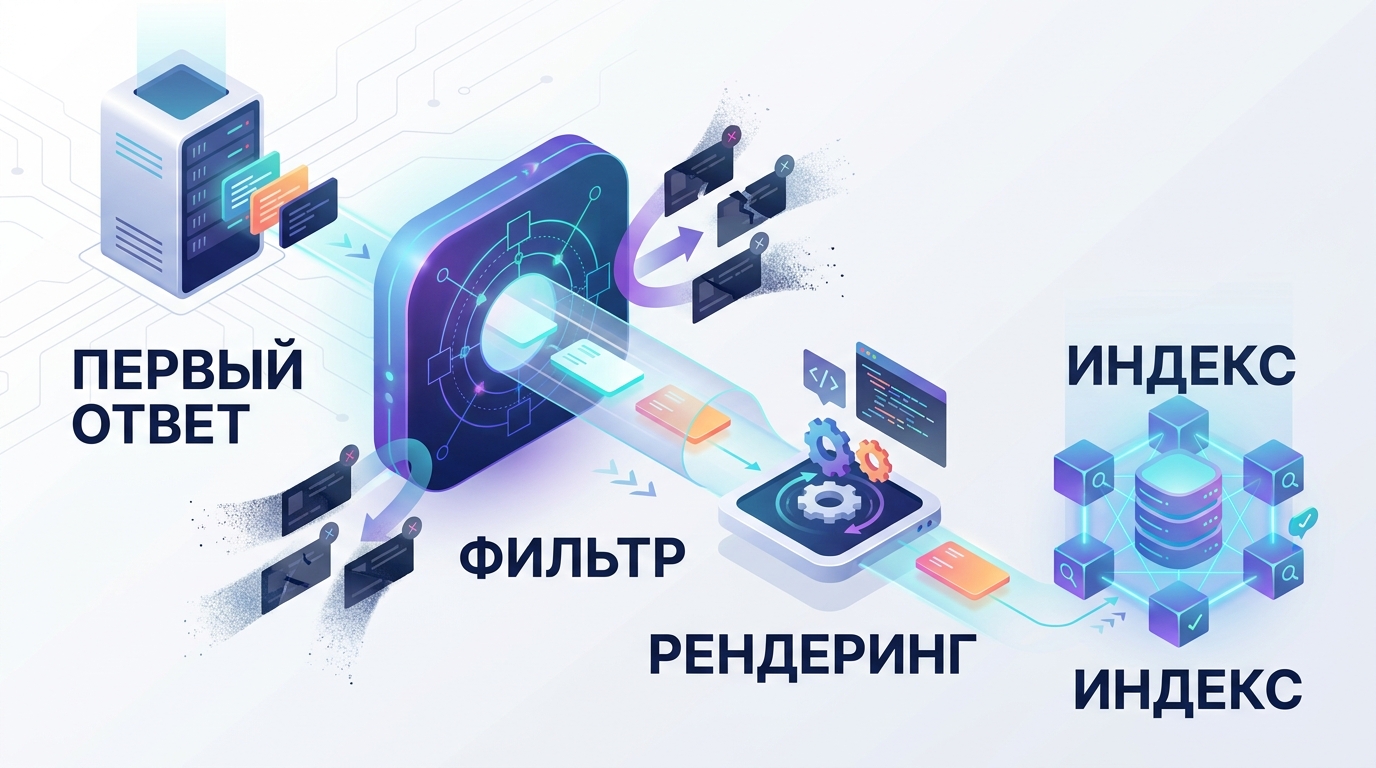
Параметры в URL тормозят рендеринг сильнее, чем тяжёлый JavaScript
Вот неочевидное. В том же замере Vercel и MERJ адреса без query-строки доходили до рендера за 22 секунды на 75-м перцентиле, а с параметрами — за 31 минуту. На 90-м перцентиле разрыв растёт: 2,5 часа против 8,5. Связи между сложностью JavaScript и задержкой рендеринга при этом не нашли.
Читается это так: хвосты вида ?ref= и ?utm_, которые не меняют контент, растягивают ожидание в десятки раз. Обвесили внутренние ссылки параметрами — платите неделями на переиндексации, а не краулинговым бюджетом.
Чинить теперь надо не для Googlebot
Здесь поворот 2026 года. Googlebot JavaScript выполняет, а краулеры нейросетей — нет. В замере Vercel и MERJ (декабрь 2024) GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot и Bytespider ни разу не выполнили клиентский код: читают сырой HTML и уходят. Исключения — Gemini, который едет на инфраструктуре Googlebot, и AppleBot.
Client-side rendering сегодня бьёт не по индексу Google, а по цитируемости в ответах нейросетей. Server-side rendering перестал быть страховкой для SEO и стал условием, чтобы вас вообще прочитали.
Начните с фактов, а не с гипотез. Прогоните список страниц через массовую проверку индексации в Google — SpeedyIndex вернёт статус по каждому URL, и станет видно, спорит бот с рендерингом или вообще не дошёл до страницы. Спорные адреса добейте инспекцией URL в Search Console: вкладка отрендеренного HTML показывает ровно то, что увидел краулер. Тот же список проверьте в Яндекс Вебмастере — статусы обхода там свои.
Пять причин выше закрываются за вечер. Фронтенд трогайте последним — и посмотрите официальную документацию Google по JavaScript-SEO, прежде чем закладывать переезд на SSR.