Count Min Sketch
rawoakСегодня я хочу рассказать про такую интересную структуру данных, как Count Min Sketch. И в духе хороших презентаций сразу скажу, что эта структура данных помогает красиво и элегантно решить Heavy Hitters Problem.
Суть этой проблемы заключается в следующем: на вход подается очень большой поток данных, содержащий в себе много разных элементов, требуется найти элементы, встречающиеся чаще всего.
Первое что приходит на ум - взять какой-нибудь словарь, или массив и запоминать элементы, сравнивать и что-то в таком духе.
Однако, как ловкий фокусник, сейчас я достану из рукава ещё одну карту и добавлю ещё одну вводную - мы сильно ограничены по памяти и времени, то есть места чтобы хранить много элементов нам банально не хватит, тем более, работать надо быстро.
И чтобы не быть голословным, сразу скажу, что такая задача действительно существует, например, при анализе интернет трафика, когда маршрутизатору необходимо определить потоки данных, через которые проходит большая часть траффика. Ну или более «бизнесовый» пример - определение пар на бирже с наибольшей волатильностью.
А теперь - самое интересное. Как это всё, черт возьми, работает? Count Min Sketch по сути своей таблица из B столбцов и L строк, где каждой строке соответствует своя хэш функция h_i, которая на выходе дает значения от нуля до B. Структура CMS имеет две операции - Inc, добавить элемент (т.е. учесть его) и Count, посчитать сколько раз этот элемент встречался.
Процедура добавления: берём входной элемент x, для каждой хэш функции h_i вычисляем её значение от этого x - h_i(x). Это значение есть индекс ячейки в строке, соответствующей этой хэш функции. Прибавляем 1 к значению этой ячейки.
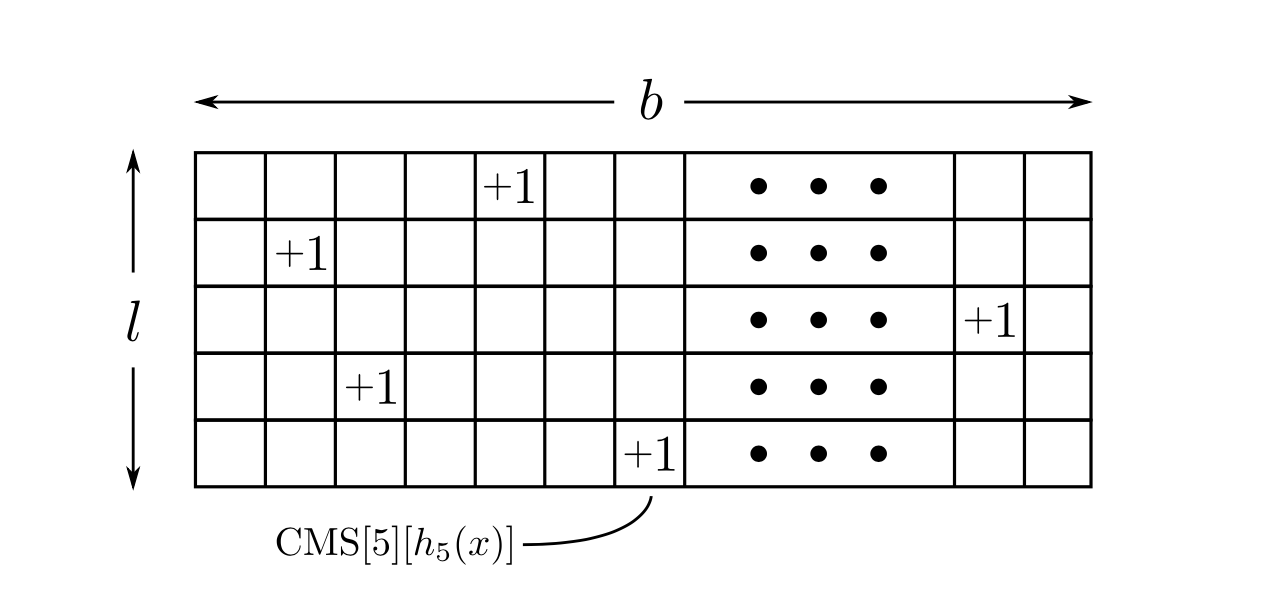
Процедура подсчёта: берём элемент x, для каждой хэш функции h_i вычисляем её значение от x - h_i(x). Дальше, среди всех строк i находим минимальный элемент CMS[i][h_i(x)] - это и будет нашей оценкой количества добавлений этого элемента в Count Min Sketch.
К слову про параметры, для большинства задач хватает L = 5 и B = 256. Поразительно, правда? Такая небольшая с точки зрения занимаемой памяти структура, а так хорошо считает. При более детальном рассмотрении можно догадаться, что такая структура данных всё таки иногда может ошибаться при подсчёте элементов. Однако приятным бонусом является то, что Count Min Sketch может ошибаться только в одну сторону - в большую. То есть он только переоценивает количество добавлений элемента и никогда не недооценивает их. Почитать подробнее про оценку ошибок можно в методичке от Stanford.