8. Исследование веб-сайтов
Investigations|BelarusАвтор: Крейг Сильверман - медиаредактор BuzzFeed News, где он ведет глобальную рубрику, посвященную платформам, онлайновой дезинформации и манипулированию СМИ. Ранее он редактировал "Руководство по проверке" и "Руководство по проверке для журналистских расследований", а также является автором книги "Ложь, проклятая ложь и вирусный контент: Как новостные сайты распространяют (и развенчивают) в Интернете слухи, недостоверные утверждения и дезинформацию".
Веб-сайты используются теми, кто занимается манипулированием СМИ, для получения прибыли, сбора электронных писем и другой личной информации, а также для создания иного плацдарма в Интернете. Журналисты должны понимать, как расследовать присутствие в Интернете и, по возможности, связывать его с более крупной операцией, в которой могут участвовать аккаунты в социальных сетях, приложения, компании или другие организации.
Помните, что текст, изображения или сам сайт могут со временем исчезнуть - особенно после того, как вы начнете связываться с людьми и задавать вопросы. Лучше всего использовать Wayback Machine для сохранения важных страниц на целевом сайте в рамках своей работы. Если страница не сохраняется должным образом, воспользуйтесь таким инструментом, как archive.today. Это позволит вам ссылаться на архивные страницы в качестве доказательства того, что вы нашли, и избежать прямой ссылки на сайт, распространяющий ложную/дезинформационную информацию. (Hunchly - отличный платный инструмент для автоматического создания личного архива веб-страниц во время работы). Эти инструменты архивирования также необходимы для изучения того, как выглядел сайт с течением времени. Я также рекомендую установить расширение для браузера Wayback Machine, чтобы можно было легко архивировать страницы и просматривать более ранние версии.
Еще одно полезное расширение для браузера - Ghostery, которое показывает, какие трекеры присутствуют на веб-странице. С его помощью можно быстро определить, использует ли сайт идентификаторы GoogleAnalytics и/или Google AdSense, что поможет применить одну из описанных ниже методик.
В этой главе мы рассмотрим четыре категории, которые необходимо анализировать при исследовании сайта: контент, код, аналитика, регистрация и связанные элементы.
Содержание/Контент
Большинство веб-сайтов хотя бы немного рассказывают о том, что они собой представляют. Будь то специальная страница "О сайте", описание в нижнем колонтитуле или где-то еще, это хорошее начало. В то же время отсутствие четкой информации может свидетельствовать о том, что сайт создавался в спешке или пытается скрыть подробности о своем владельце и назначении.
Наряду с прочтением основного текста "О сайте" необходимо тщательно изучить содержимое сайта, чтобы определить, кто им управляет, какова его цель, является ли он частью более крупной сети или инициативы. На что следует обратить внимание:
Указан ли на странице "О сайте" его владелец или какая-либо корпоративная структура? Также обратите внимание, нет ли у него страницы "О сайте".
Не указана ли компания или лицо в уведомлении об авторских правах в самом низу главной или любой другой страницы? Указаны ли какие-либо имена, адреса или юридические лица в политике конфиденциальности или правилах и условиях? Отличаются ли эти названия или компании от тех, что указаны в нижнем колонтитуле, на странице "О сайте" или в других местах на сайте?
Если на сайте публикуются статьи, обратите внимание на подстрочные примечания и на то, являются ли они кликабельными ссылками. Если да, то посмотрите, не ведут ли они на страницу автора с дополнительной информацией, например, биографией или ссылками на социальные аккаунты автора.
Есть ли на сайте связанные с ним социальные аккаунты? Это могут быть небольшие значки в верхней, нижней или боковой части главной страницы или вставка, приглашающая, например, подписаться на страницу в Facebook. Если на странице отображаются значки таких платформ, как Facebook и Twitter, наведите на них курсор мыши и посмотрите в левую нижнюю часть окна браузера, чтобы увидеть URL, на который они ведут. Часто при поспешном создании сайта в шаблоне не удосуживаются указать идентификаторы социальных платформ. В этом случае ссылка будет отображаться как facebook.com/ без имени пользователя.
Перечислены ли на сайте продукты, клиенты, отзывы или другие люди или компании, которые могут иметь связь и заслуживают внимания?
Обязательно просмотрите не только главную страницу. Щелкните по всем основным меню и прокрутите страницу вниз до нижнего колонтитула, чтобы найти другие страницы, которые стоит посетить.
Важной частью изучения контента является проверка его оригинальности. Не скопирован ли текст со страницы "О сайте" или другой общий текст из других мест? Не распространяет ли сайт ложную или недостоверную информацию, не способствует ли продвижению конкретной повестки дня?
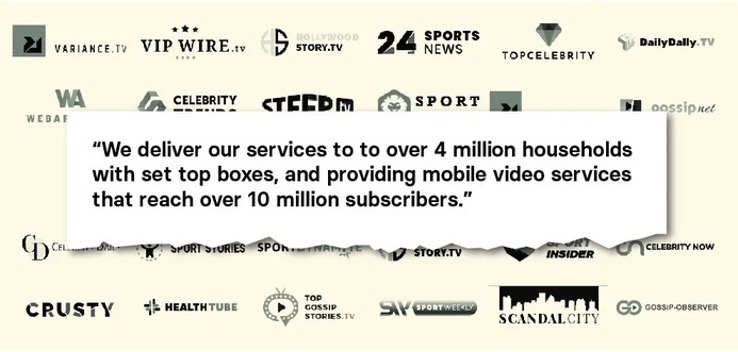
В 2018 году я расследовал крупную схему мошенничества в сфере цифровой рекламы, в которой были задействованы мобильные приложения и контентные сайты, а также подставные компании, фиктивные сотрудники и подставные фирмы. В итоге я обнаружил более 35 сайтов, связанных с этой схемой. Многие сайты я идентифицировал, скопировав текст на странице "О сайте" и вставив его в поисковую строку Google. Я сразу же нашел около 20 сайтов с точно таким же текстом:
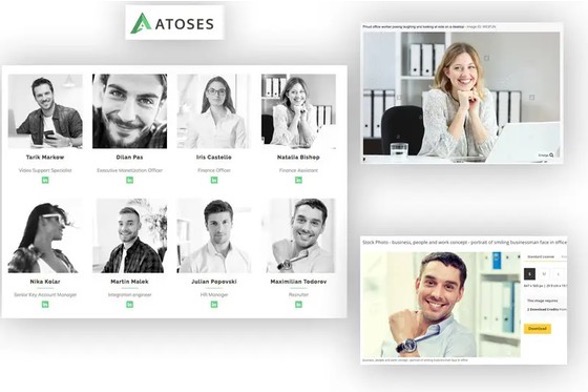
Мошенники также создавали сайты для своих подставных компаний, чтобы они выглядели легитимно, когда потенциальные партнеры из рекламных сетей посещали их для проведения проверки. В качестве примера можно привести компанию Atoses. На ее главной странице были указаны фотографии нескольких сотрудников. Обратный поиск по картинкам Яндекса (лучший поиск по лицам) быстро показал, что некоторые из них являются стоковыми изображениями:
В нижнем колонтитуле сайта компании Atoses также был размещен следующий текст: "Мы создаем красивые полезные, связанные экосистемы, которые развивают бизнес и строят прочные отношения между сетевыми СМИ и пользователями".
Этот же текст присутствует на сайтах как минимум двух маркетинговых агентств:
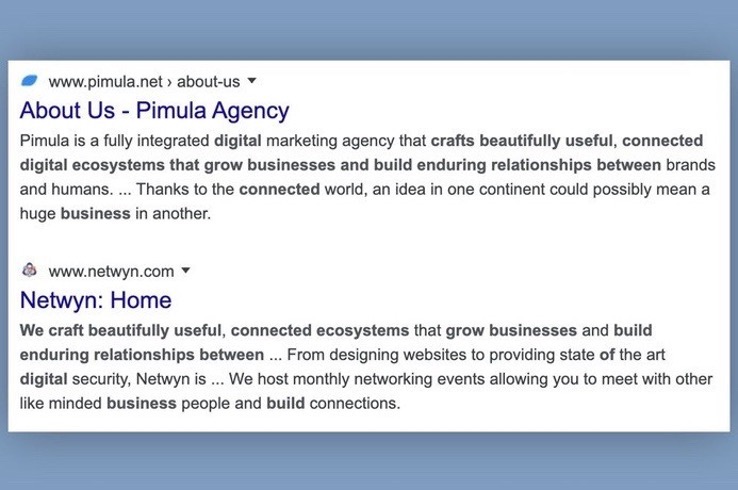
Если компания использует стоковые изображения для сотрудников и плагиатный текст на своем сайте, это означает, что она не соответствует заявленным характеристикам.
Нелишним будет скопировать и вставить текст из статей на сайте и ввести его в Google или другую поисковую систему. Иногда сайт, выдающий себя за источник новостей, просто плагиатит реальные издания.
В 2019 году я столкнулся с сайтом forbesbusinessinsider.com, который выглядел как новостной сайт, освещающий технологическую отрасль. На самом деле это был массовый плагиат статей из самых разных изданий, включая, как это ни смешно, статью о фальшивых местных сайтах, которую я написал.
Еще один базовый шаг - взять URL-адрес сайта и поискать его в Google. Например, "forbesbusinessinsider.com". Это даст вам представление о том, сколько страниц сайта было проиндексировано, а также может привести примеры того, как другие люди писали о сайте или рассказывали о нем. Вы также можете проверить, есть ли сайт в списке Google News, загрузив главную страницу Google News и введя в поисковую строку "forbesbusinessinsider.com".
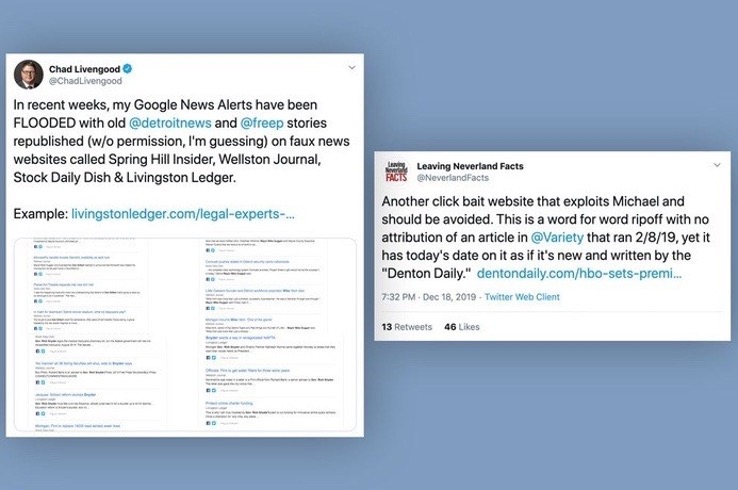
Еще один совет - возьмите URL-адрес сайта и вставьте его в строки поиска на сайтах Twitter.com или Facebook.com. Это покажет, ссылаются ли люди на этот сайт. В ходе одного расследования я наткнулся на сайт dentondaily.com. На его главной странице было представлено всего несколько статей начала 2020 года, но когда я поискал домен в Twitter, то увидел, что ранее на нем размещались плагиаты, что вызвало недовольство людей. Эти старые статьи были удалены с сайта, но в твитах остались свидетельства его прежнего поведения.
Разобравшись с содержанием сайта, необходимо понять, как он распространяется. Для этого мы рассмотрим два инструмента: BuzzSumo и CrowdTangle.
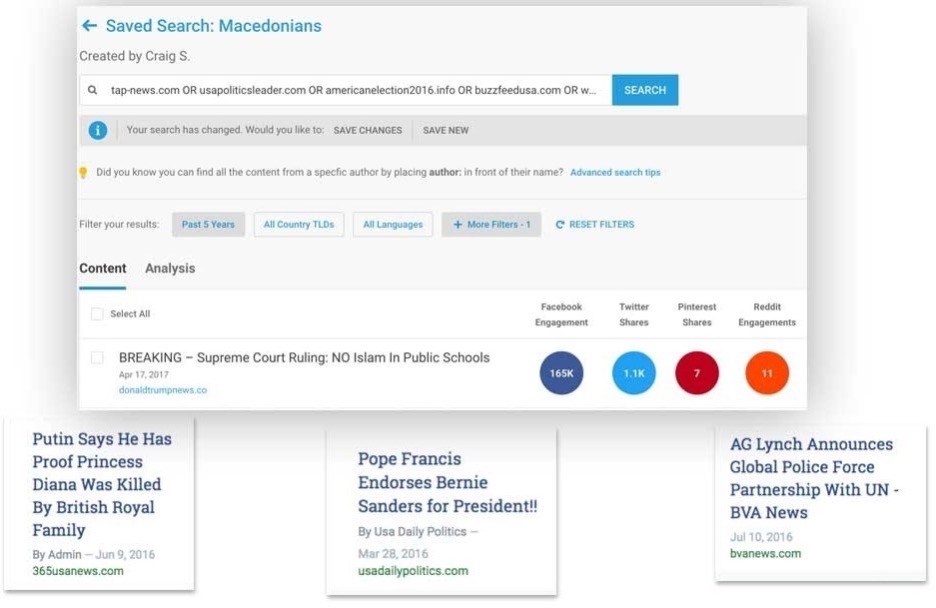
В 2016 году я вместе с исследователем Лоуренсом Александером изучал американские новостные политические сайты, управляемые из-за рубежа. Вскоре мы вышли на сайты, управляемые из Велеса, города в Северной Македонии. Используя данные о регистрации доменов (подробнее об этом ниже), мы выявили более 100 американских политических сайтов, управляемых из этого города. Я хотел получить представление о том, насколько популярен их контент и какого рода материалы они публикуют. Я взял URL-адреса нескольких сайтов, которые показались мне наиболее активными, и создал для них поиск в BuzzSumo - инструменте, который может показать список материалов сайта, ранжированных по степени вовлеченности в Facebook, Twitter, Pinterest и Reddit. (У этого инструмента есть бесплатная версия, но платный продукт предлагает гораздо больше результатов).
Я сразу же увидел, что статьи с этих сайтов с наибольшей вовлеченностью в Facebook были абсолютно ложными. Это дало нам ключевую информацию и позволило взглянуть на ситуацию под углом, отличным от предыдущих отчетов. На рисунке ниже показан основной экран результатов поиска BuzzSumo, на котором перечислены показатели вовлеченности в Facebook, Twitter, Pinterest и Reddit для конкретного сайта, а также несколько примеров ложных историй 2016 года:
Другой способ определить, как контент сайта распространяется в Facebook, Twitter, Instagram и Reddit, - установить бесплатное расширение для браузера CrowdTangle или воспользоваться его веб-инструментом для поиска ссылок. Оба варианта обладают одинаковой функциональностью, но мы будем работать с веб-версией. (Эти инструменты бесплатны, но для доступа к ним требуется учетная запись Facebook).
Основное различие между BuzzSumo и CrowdTangle заключается в том, что в BuzzSumo можно ввести URL-адрес сайта, и он автоматически поднимет наиболее активный контент на этом сайте. CrowdTangle используется для проверки конкретного URL-адреса сайта. Так, если ввести buzzfeednews.com, CrowdTangle покажет статистику вовлеченности только для этой домашней страницы, в то время как BuzzSumo просканирует весь домен в поисках лучшего контента. Еще одно отличие заключается в том, что инструмент поиска ссылок и расширение CrowdTangle покажут количество вовлечений в Twitter только за последние семь дней. BuzzSumo предоставляет подсчет общего количества просмотров в Twitter для статей на сайте.
В качестве примера я ввел в CrowdTangle Link Search URL старой, ложной статьи о предупреждении о необходимости кипячения воды в Торонто. (Позже сайт удалил эту статью, но URL-адрес все еще активен на момент написания статьи). CrowdTangle показывает, что с момента публикации этот URL-адрес получил более 20 000 откликов, комментариев и перепостов на Facebook. Также показаны некоторые страницы и публичные группы, которые поделились ссылкой, и предлагается возможность просмотреть аналогичные данные для Instagram, Reddit и Twitter. Помните: На вкладке Twitter отображаются твиты только за последние семь дней.
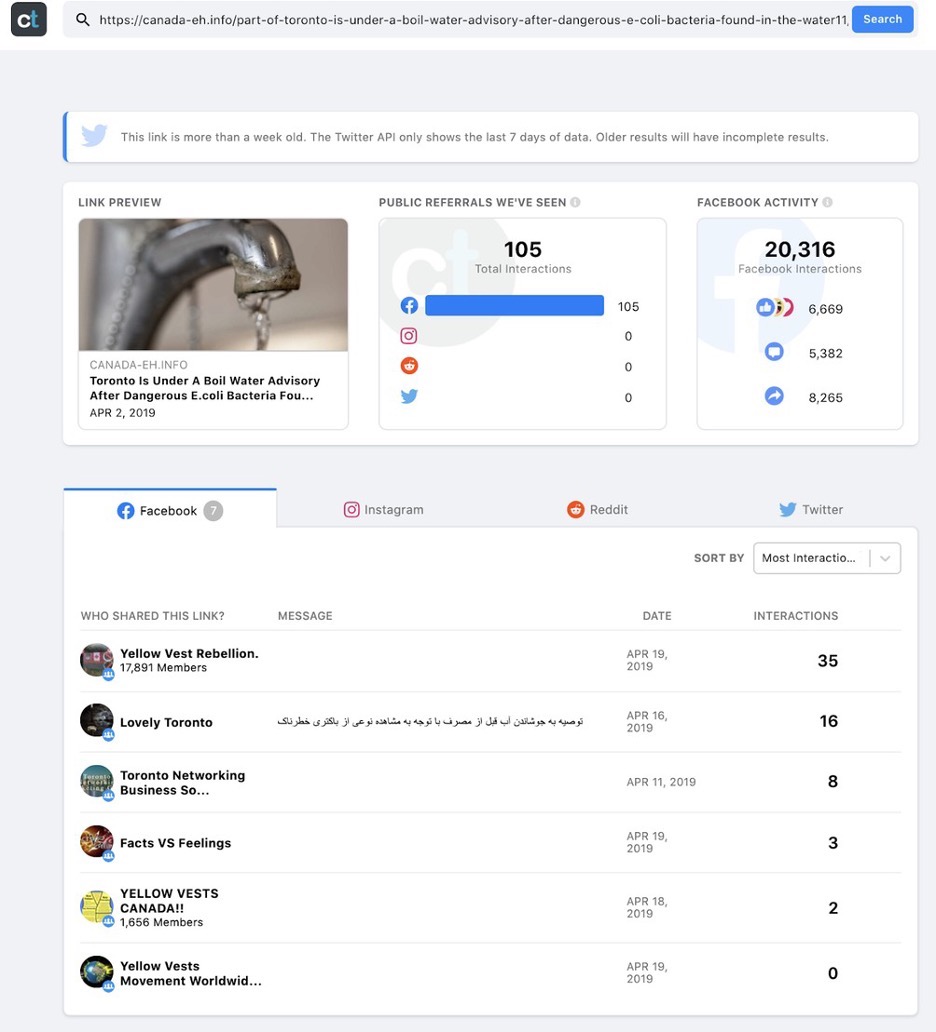
Отметим, что большое количество общих взаимодействий с Facebook не очень отражается на небольшом списке страниц и групп, которые мы видим. По крайней мере отчасти это объясняется тем, что некоторые ключевые страницы, распространявшие ссылку при ее первой публикации, впоследствии были удалены Facebook. Это полезное напоминание о том, что CrowdTangle показывает данные только по активным учетным записям, и не покажет вам все публичные учетные записи, которые поделились данным URL. Это выборка, но она все равно невероятно полезна, поскольку часто позволяет выявить четкую связь между конкретными аккаунтами в социальных сетях и веб-сайтом. Если одна и та же страница Facebook постоянно (или исключительно) делится контентом с какого-либо сайта, это может свидетельствовать о том, что ими управляют одни и те же люди. Теперь можно покопаться на странице, сопоставить информацию с сайтом и, возможно, определить причастных к этому людей и их мотивы. Некоторые из результатов обмена ссылками в Facebook, приведенных в CrowdTangle, могут быть также связаны с тем, что люди поделились статьей в группе Facebook. Обратите внимание на аккаунт, который поделился ссылкой, и посмотрите, распространяли ли они другие материалы с этого сайта. Опять же, здесь может быть связь.
Регистрация
Каждое доменное имя в Интернете является частью центральной базы данных, в которой хранится основная информация о его создании и истории. В некоторых случаях нам также везет, и мы получаем информацию о физическом или юридическом лице, заплатившем за регистрацию домена. Эту информацию можно получить с помощью поиска по whois, который предлагается многими бесплатными программами. Есть также несколько отличных бесплатных и недорогих инструментов, позволяющих получить дополнительную информацию, например, о том, кто владел доменом в течение определенного времени, на каких серверах он был размещен, и другие полезные сведения.
Одна оговорка: защита личной информации при регистрации домена стоит относительно недорого. Если при поиске домена в системе whois в качестве регистратора указывается что-то вроде "Registration Private", "WhoisGuard Protected" или "Perfect Privacy LLC", это означает, что домен защищен.
Но даже в этих случаях поиск по whois все равно позволит узнать дату последней регистрации домена, срок его действия и IP-адрес в Интернете, на котором размещен сайт.
DomainBigData - один из лучших бесплатных инструментов для изучения доменного имени и его истории. Вы также можете ввести адрес электронной почты, имя человека или компании для поиска по этим данным, а не по URL. Другие доступные сервисы, которые вы можете добавить в закладки, - это DNSlytics, Security Trails и Whoisology. Отличным, но более дорогим вариантом является продукт Iris investigations компании DomainTools.
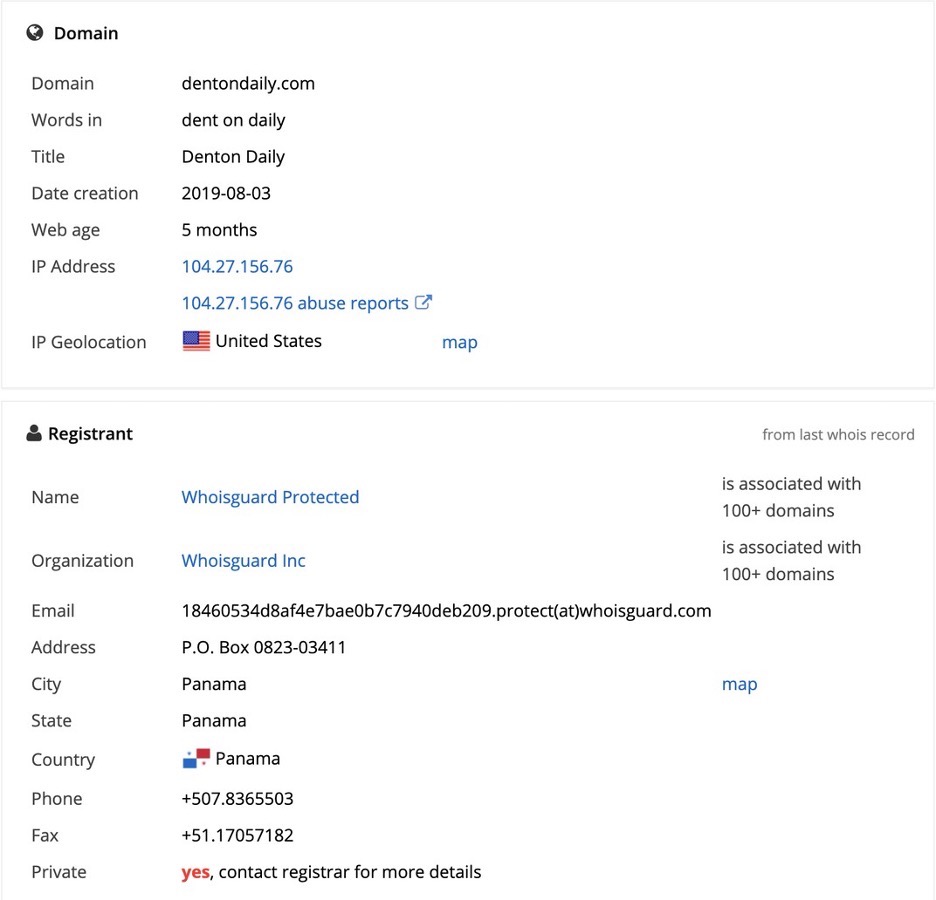
Например, если мы введем в DomainBigData домен dentondaily.com, то увидим, что он защищен от посторонних глаз. Имя регистратора указано как "Whoisguard Protected". К счастью, мы все еще видим, что последний раз он был зарегистрирован в августе 2019 года.
В качестве другого примера приведем поиск newsweek.com в DomainBigData. Сразу видно, что владелец не заплатил за защиту конфиденциальности. Есть название компании, адрес электронной почты, номера телефона и факса.
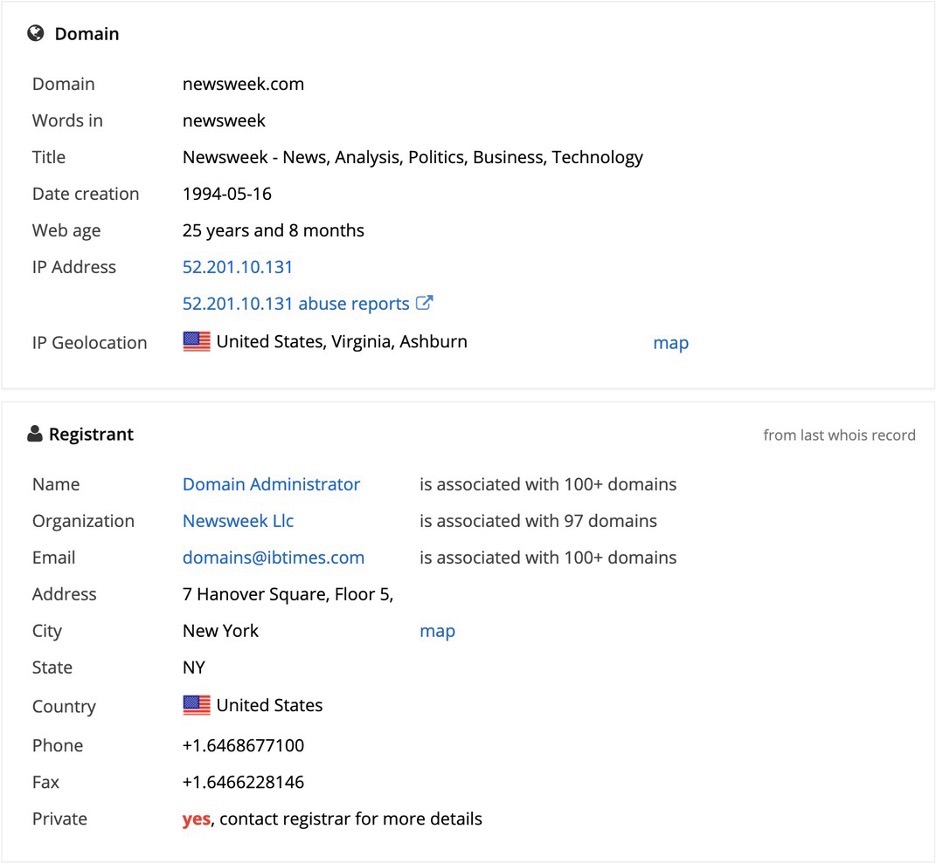
Мы также видим, что эта организация владеет доменом с мая 1994 года, и что в настоящее время сайт размещен на IP-адресе 52.201.10.13. Следующее, на что следует обратить внимание, - это то, что название компании, адрес электронной почты и IP-адрес выделены как ссылки. Это означает, что они могут вести на другие домены, принадлежащие Newsweek LLC, domains@ibtimes.com и другие сайты, размещенные на этом же IP-адресе. Такие связи невероятно важны для расследования, поэтому всегда важно проверять другие домены, принадлежащие тому же физическому или юридическому лицу.
Что касается IP-адресов, то следует иметь в виду, что на одном и том же сервере могут быть размещены совершенно не связанные между собой сайты. Обычно это происходит потому, что люди используют для своих сайтов одну и ту же хостинговую компанию. Общее правило гласит: чем меньше сайтов размещено на одном сервере, тем больше вероятность того, что они связаны между собой. Однако это не точно.
Если вы видите сотни сайтов, размещенных на одном сервере, то, возможно, они не имеют связи между собой. Но если вы видите, что их всего девять, например, а интересующий вас сайт имеет закрытую регистрационную информацию, стоит выполнить поиск по whois по восьми другим доменам, чтобы выяснить, есть ли у них общий владелец и возможно ли, что этот человек также владеет интересующим вас сайтом. Люди могут платить за защиту конфиденциальности на одних доменах, но не делать этого на других.
Соединение сайтов с помощью IP, контента и/или регистрационной информации является одним из основных способов выявления сетей и стоящих за ними лиц.
Теперь давайте рассмотрим другой способ связи сайтов - с помощью кода веб-страницы.
Код и аналитика
Этот подход, впервые открытый Лоуренсом Александером, начинается с просмотра исходного кода веб-страницы и последующего поиска в нем кода Google Analytics и/или Google AdSense. Это очень популярные продукты компании Google, которые, соответственно, позволяют владельцу сайта отслеживать его статистику или зарабатывать на рекламе. После интеграции на сайте каждая веб-страница будет иметь уникальный идентификатор, связанный с учетной записью владельца в Analytics или AdSense. Если владелец ведет несколько сайтов, то для управления ими часто используется одна и та же учетная запись Analytics или AdSense. Это дает следователю возможность связать, казалось бы, разные сайты, найдя в исходном коде один и тот же идентификатор. К счастью, сделать это несложно.
Сначала перейдите на целевой сайт. Возьмем, например, сайт dentondaily.com. В Chrome для Mac выберите меню "Вид", затем "Разработчик" и "Просмотр исходного кода". Откроется новая вкладка с исходным кодом страницы. (В Chrome для PC нажмите ctrl- U.)

Все идентификаторы Google Analytics начинаются с "ua-", а затем содержат строку цифр. Идентификаторы AdSense содержат "pub-" и строку цифр. Найти их в исходном коде можно, просто выполнив команду " find" на странице. На Mac наберите command-F, на PC - ctrl-F. Появится небольшое окно поиска. Введите "ua-" или "pub-", и вы увидите все идентификаторы на странице.
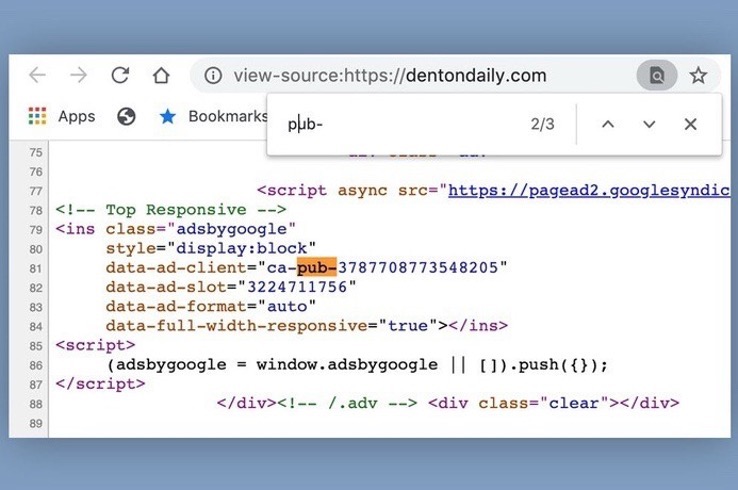
Если вы нашли идентификатор, скопируйте его и вставьте в поле поиска в таких сервисах, как SpyOnWeb, DNSlytics, NerdyData или AnalyzeID. Обратите внимание, что зачастую каждый сервис получает разные результаты, поэтому важно протестировать идентификатор и сравнить результаты. На приведенном ниже изображении видно, что SpyOnWeb нашел три домена с одним и тем же идентификатором AdSense, а DNSlytics и AnalyzeID - еще несколько.

Иногда сайт имел идентификатор в прошлом, но теперь его нет. Поэтому необходимо использовать тот же подход к просмотру источников на других сайтах, где предположительно указаны эти идентификаторы, чтобы убедиться в их наличии. Обратите внимание, что идентификаторы AdSense и Analytics по-прежнему присутствуют в архивной версии сайта на Wayback Machine. Поэтому если вы не обнаружили идентификатор на действующем сайте, обязательно проверьте его в Wayback Machine.
Все эти сервисы предоставляют некоторые результаты бесплатно. Но для получения полных результатов часто приходится платить, особенно если ваш идентификатор присутствует на большом количестве других сайтов.
И последнее замечание по проверке исходного кода: Сканировать всю страницу стоит даже в том случае, если вы не понимаете HTML, JavaScript, PHP и других распространенных языков веб-программирования. Например, люди иногда забывают изменить заголовок страницы или сайта, если они используют один и тот же шаблон дизайна. Эта простая ошибка может дать точку соприкосновения.
В ходе расследования схемы рекламного мошенничества с подставными компаниями типа Atoses меня заинтересовала компания под названием FLY Apps. Я посмотрел исходный код ее одностраничного сайта и увидел в верхней части кода сайта слово "Loocrum", написанное обычным шрифтом (выделено мной):
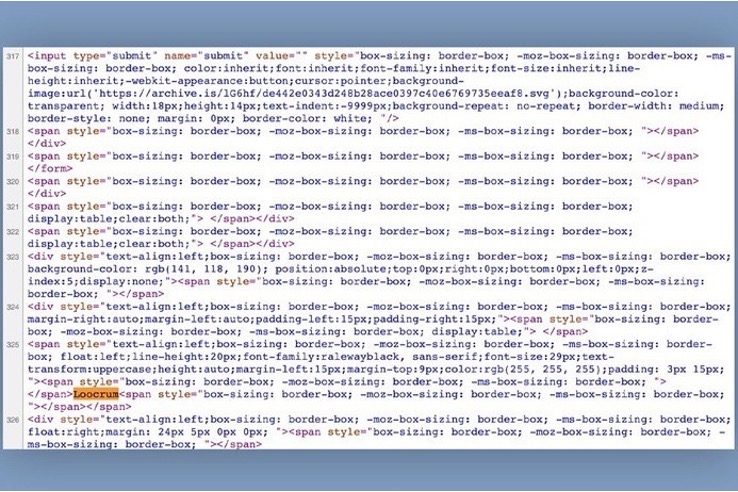
В результате поиска по этому слову была обнаружена компания Loocrum, которая использовала точно такой же дизайн сайта, как и FLY Apps, и имела примерно такое же содержание. Поиск по сайту whois показал, что адрес электронной почты, использовавшийся для регистрации сайта loocrum.com, также использовался для регистрации других подставных компаний, которые я ранее идентифицировал в этой схеме. Эта связь между FLY Apps и Loocrum послужила важным дополнительным доказательством того, что четыре человека, управлявшие FLY Apps, были связаны с этой общей схемой. Она была обнаружена простым пролистыванием исходного кода в поисках слов, которые показались мне неуместными.
Заключение
Даже имея на вооружении все вышеперечисленные подходы и инструменты, иногда может возникнуть ощущение, что вы зашли в тупик. Но часто на сайте есть и другой способ найти связи или пути для дальнейшего исследования. Переходите по всем ссылкам, изучайте содержание, читайте исходный код, смотрите, кто создал сайт, кто им делится, и изучайте все, что только можно придумать, чтобы понять, что происходит на самом деле.